

Eine mRNA-LNP-Formulierung hat vier molare Lipidanteile, die sich zu 100 summieren müssen, ein N/P-Verhältnis, die Wahl des ionisierbaren Lipids und mindestens vier Zielgrößen, die Sie gleichzeitig interessieren: Verkapselungseffizienz, Partikelgröße, Polydispersität und Expression. Ein Screening, das jeweils nur einen Faktor verändert, kostet in diesem Raum Wochen an RNA und Nanopräzipitationsläufen, bevor Sie wissen, ob das neue ionisierbare Lipid die Herstellung überhaupt wert war. Die nützliche Frage ist nicht „was ist die beste Formulierung“, sondern „welche zwölf dieser hundert Kandidaten verdienen Laborzeit“.
Dieser Artikel führt durch den Triage-Workflow mit der LNP-Auswertung von CovaSyn. Jede Zahl im Folgenden ist unverändert übernommen, und die Vorbehalte stehen direkt neben den Zahlen.
Was die Auswertung macht
Sie ist ein Modellsystem für LNP-Formulierungen, das direkt auf SMILES arbeitet. Sie geben das ionisierbare Lipid als Struktur ein, nicht als Namen aus einer Nachschlagetabelle, dazu die molaren Anteile von Helferlipid, Cholesterin und PEG-Lipid sowie das N/P-Verhältnis. Zurück kommt ein Satz prognostizierter Eigenschaften. Weil das Lipid als SMILES eingeht, lässt sich eine neuartige hauseigene Struktur, die nie synthetisiert wurde, genauso bewerten wie DLin-MC3-DMA.
Vier Schritte decken den Workflow ab:
| Schritt | Was er beantwortet |
|---|---|
| Einzelprognose | Eine Formulierung bewerten: Verkapselungseffizienz, Größe, PDI, Expression |
| Optimierung | Suche über Lipidanteile und N/P bei mehreren Zielgrößen |
| Vergleich | Direkter Vergleich ionisierbarer Lipide bei abgeglichenen Verhältnissen |
| Vorschlag | Welches Experiment als Nächstes, geordnet nach erwartetem Informationsgewinn |
Schritt 1: die Referenz bewerten, der Sie bereits vertrauen
Beginnen Sie mit einer Formulierung, die Sie im Labor bereits hergestellt haben. DLin-MC3-DMA ist das etablierte Standardlipid für siRNA und nach wie vor die Referenz, an der sich die meisten Gruppen orientieren.
Die Prognose für ein MC3-mRNA-LNP bei 50 / 10 / 38,5 / 1,5 molar (ionisierbar / DSPC / Cholesterin / PEG-Lipid), N/P 6, lieferte:
- Verkapselungseffizienz: 86,3 %
- Partikelgröße: 94,9 nm
- PDI: 0,150
- Prognostizierte Expression: 3,56 (HeLa)
Ein einziger Lauf liefert alle vier Größen. Der Punkt ist nicht, dass 86,3 % eine Garantie sind. Der Punkt ist, dass Sie jetzt eine modellinterne Referenz auf derselben Skala haben wie jeder Kandidat, den Sie gleich screenen, sodass Unterschiede zwischen Kandidaten etwas bedeuten, auch wenn der Absolutwert fehlerbehaftet ist.
Lesen Sie die Expression genau: 3,56 ist ein einheitenloser Modell-Score, bei dem ein höherer Wert besser ist. Es ist kein Luciferase-Messwert, kein Anteil transfizierter Zellen und lässt sich in keines von beidem umrechnen. Behandeln Sie ihn ausschließlich als Rangsignal.
Schritt 2: die Verhältnisse optimieren, nicht nur das Lipid
Die meisten Formulierungsgruppen legen das ionisierbare Lipid fest und stellen dann die Verhältnisse per Hand ein. Genau dort zeigt eine Optimierung über mehrere Zielgrößen ihren Nutzen, denn Verkapselung, Größe und PDI verändern sich nicht gleichsinnig.
Die Optimierung durchsucht den Raum aus ionisierbarem Lipid, Helferlipid, Cholesterin, PEG-Lipid und N/P unter Ihren Nebenbedingungen und liefert eine Pareto-Front statt einer einzelnen Antwort. Ausgehend von einer MC3-Startformulierung mit prognostizierten 77,3 % Verkapselung reichte die Front von 80,2 % bis 88,0 % Verkapselung, wobei jeder Kandidat auf der Front alle Nebenbedingungen erfüllte.
Der beste Kandidat bei der Verkapselung:
| Komponente | Molar % |
|---|---|
| DLin-MC3-DMA (ionisierbar) | 30,7 |
| DOPE (Helferlipid) | 15,3 |
| Cholesterin | 51,2 |
| DMG-PEG2000 | 2,8 |
| N/P-Verhältnis | 3,9 |
Prognostizierte Verkapselung: 88,0 %. Die benachbarten Pareto-Punkte lagen bei 83,3 % und 82,1 %; die Front ist also tatsächlich breit und keine Ansammlung nahezu identischer Lösungen.
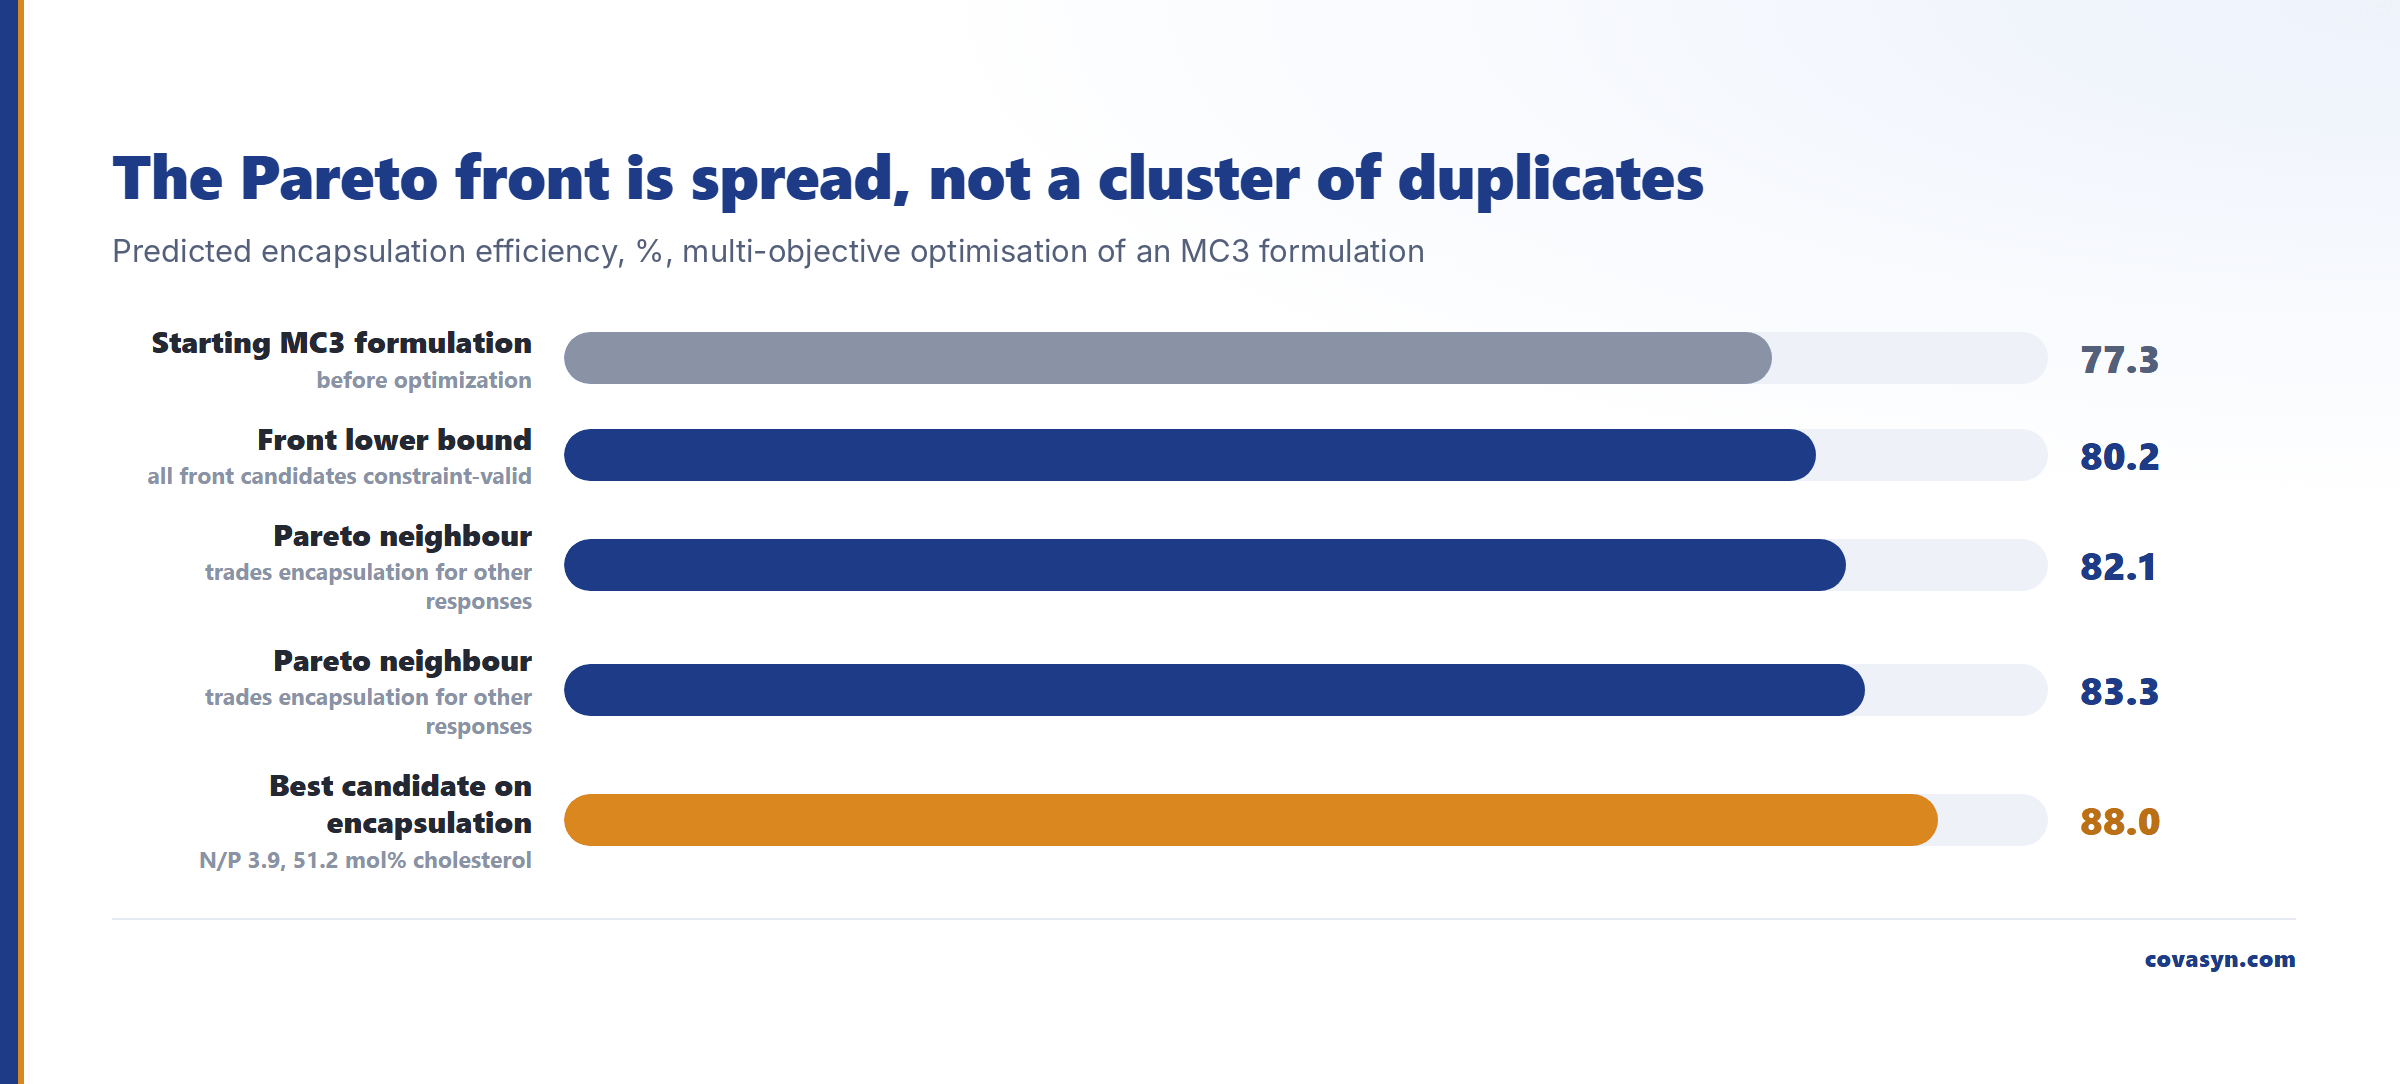
Zwei Dinge sollten einem Formulierer sofort auffallen. Die Optimierung erhöhte das Cholesterin auf 51,2 mol-% und senkte das ionisierbare Lipid auf 30,7 mol-%, deutlich weg von der üblichen Zusammensetzung 50 / 10 / 38,5 / 1,5. Und sie senkte das N/P von 6 auf 3,9. Beides sind überprüfbare Vorhersagen, und genau darin liegt der Wert. Sie erhalten wenige, bewusst nicht naheliegende Verhältniskombinationen für das Labor statt eines Rasters um das herum, was Sie ohnehin schon tun.
Ehrlicher Hinweis zu diesem Lauf: Die Verkapselung kommt zuverlässig zurück, die prognostizierte Transfektion kam in unseren Läufen jedoch als 0,0 zurück, offenkundig fehlerhaft und keine echte Prognose. Behandeln Sie den Optimierungsschritt daher als Schritt für Verkapselung und Nebenbedingungen und holen Sie Expression und Größe für die engere Auswahl aus Einzelprognose oder Vergleich. Stützen Sie keine Argumentation auf einen Wert, der ein Platzhalter ist.
Schritt 3: ionisierbare Lipide direkt vergleichen
Die Feinabstimmung der Verhältnisse hat eine Obergrenze. Ein Wechsel des ionisierbaren Lipids bewirkt mehr.
Der Vergleich bei abgeglichenen Verhältnissen, MC3 gegen ALC-0315, per SMILES eingegeben:
| Zielgröße | MC3 | ALC-0315 | Richtung |
|---|---|---|---|
| Expression (einheitenlos) | 3,56 | 3,81 | besser |
| Verkapselung | 77,3 % | 84,4 % | besser |
| Partikelgröße | 94 nm | 113 nm | schlechter |
Das ist die ehrliche Form eines echten Vergleichs. Zwei Zielgrößen verbessern sich, eine verschlechtert sich. Ein Partikel von 113 nm ist nicht automatisch disqualifiziert, aber wenn Ihr Zielproduktprofil eine Obergrenze nahe 100 nm vorsieht, dann sagt Ihnen das Modell gerade, dass der Wirksamkeitsgewinn Spielraum bei der Größe kostet. Das ist eine Entscheidung für einen Menschen mit dem Zielproduktprofil vor sich, nicht für einen Algorithmus.
Beachten Sie, dass ALC-0315 als SMILES übergeben wurde, nicht als Name. Eine namensbasierte Suche ließ sich in unseren Tests nicht zuverlässig in unterscheidbare Deskriptoren auflösen; SM-102 als Name lieferte etwa keine differenzierten Ergebnisse. Geben Sie immer die Struktur an.
Schritt 4: das nächste Experiment nach Information wählen, nicht nach Intuition
Wenn Sie diesen Monat nur sechs Formulierungen fahren können, lautet die Frage, welche sechs Ihnen am meisten beibringen.
Der Vorschlagsschritt ordnet Kandidaten nach erwartetem Informationsgewinn statt allein nach prognostiziertem Mittelwert. In unserem Lauf lag ALC-0315 vorn, mit prognostizierter Expression 3,81 bei einem erwarteten Informationsgewinn von 10,97; der nächste Kandidat, CKK-E12, folgte mit 3,70. Die Reihung nach Informationsgewinn statt nach dem reinen Vorhersagewert verhindert, dass sich eine Schleife des aktiven Lernens auf die eine Lipidfamilie verengt, die das Modell ohnehin schon gut kennt.
Was das nicht sagt
Seien Sie sich selbst und Ihren Gutachtern gegenüber ehrlich über die Grenzen.
- Das sind Prognosen, keine Messungen. Keine dieser Zahlen ersetzt DLS, RiboGreen, Kryo-TEM oder eine In-vivo-Messung. Der Arbeitsablauf ordnet Ihre Warteschlange um, er verkürzt die Validierung nicht.
- Expression ist ein einheitenloser Score. 3,56 gegenüber 3,81 ist eine Rangfolge, kein Faktor der Proteinexpression. Führen Sie ihn nicht in einem Bericht auf, als wäre er ein Messergebnis.
- Die Anwendungsdomäne zählt. Ein Lipid, dessen Chemie weit von der Trainingsverteilung entfernt liegt, erhält eine Prognose mit einem Fehler, den der Punktschätzer nicht zeigt. Bei neuartigen Kopfgruppen und ungewöhnlichen Linkern ist die Verlässlichkeit am geringsten.
- Die Optimierung berücksichtigt nur, was Sie als Nebenbedingung setzen. Sie kennt weder die Skalierbarkeit noch die Lösungsmittelentfernung, die Verunreinigungsprofile der Lipide, auf Stabilität bei 2 bis 8 °C oder darauf, ob Ihr PEG-Lipid-Lieferant im großen Maßstab liefern kann.
- Die Größe ist die Zielgröße, die Sie im Auge behalten sollten. In unseren Läufen gingen Gewinne bei Verkapselung und Expression wiederholt mit Größenanstiegen einher. Wenn Größe für Sie ein kritisches Qualitätsattribut ist, setzen Sie sie explizit als Nebenbedingung, statt sie im Nachhinein abzulesen.
- Merkmalszuordnung steht nicht zur Verfügung, sodass Sie Rangfolgen ohne Zuordnung auf SHAP-Ebene erhalten.
Ein realistischer Workflow
1. Prognostizieren Sie Ihre aktuelle hauseigene Formulierung. Bestätigen Sie, dass das Modell sie relativ zu MC3 dort einordnet, wo Sie es erwarten. 2. Lassen Sie die Optimierung mit Ihren realen Nebenbedingungen laufen, einschließlich einer harten Größenobergrenze. 3. Nehmen Sie die besten drei bis fünf Pareto-Punkte und bewerten Sie sie einzeln erneut, um Expression und Größe zu erhalten. 4. Vergleichen Sie Ihre zwei oder drei Kandidaten für ionisierbare Lipide beim besten Verhältnissatz direkt. 5. Stellen Sie 6 bis 12 Formulierungen im Labor her. Speisen Sie die gemessene Verkapselung und Größe zurück.
Dieser letzte Schritt ist der, der sich auszahlt. Das Modell ist Triage; Ihre Daten sind die Wahrheit.
Häufige Fragen
Was ist LNP-Formulierungsoptimierung für mRNA?
Dabei werden das ionisierbare Lipid, die molaren Anteile von Helferlipid, Cholesterin und PEG-Lipid sowie das N/P-Verhältnis so gewählt, dass Verkapselungseffizienz, Partikelgröße, Polydispersität und Expression gemeinsam das Zielproduktprofil erfüllen. Weil diese Zielgrößen gegeneinander abgewogen werden müssen, ist es ein Problem mit mehreren Zielen; eine Optimierung auf eine einzelne Zielgröße verbessert meist ein Attribut und verschlechtert unbemerkt ein anderes.
Kann die Verkapselungseffizienz vor dem Formulierungslauf prognostiziert werden?
Sie kann geschätzt werden. In unserem Lauf ergab die Prognose für ein MC3-mRNA-LNP 86,3 % Verkapselung, 94,9 nm und PDI 0,150, allein aus Lipid-SMILES und molaren Verhältnissen. Das sind Modellprognosen für die Screening-Triage, keine analytischen Messungen. Sie sind nützlich, um eine Kandidatenliste vor der Laborarbeit zu ordnen, und sie ersetzen keine RiboGreen- oder DLS-Charakterisierung.
Welches N/P-Verhältnis sollte ich für ein mRNA-LNP verwenden?
Es gibt keinen universellen Wert; es hängt vom ionisierbaren Lipid und der übrigen Zusammensetzung ab. In einem Optimierungslauf, ausgehend von einer üblichen Formulierung mit N/P 6, lag der Pareto-Kandidat mit der besten Verkapselung bei N/P 3,9, mit 30,7 mol-% ionisierbarem Lipid, 15,3 mol-% DOPE, 51,2 mol-% Cholesterin und 2,8 mol-% DMG-PEG, bei prognostizierten 88,0 % Verkapselung. Behandeln Sie das als zu testende Hypothese, nicht als Empfehlung.
Wie screene ich ein neuartiges hauseigenes ionisierbares Lipid?
Geben Sie es als SMILES an. Die Auswertung arbeitet direkt auf Strukturen, sodass ein Lipid, das nie synthetisiert wurde, genauso bewertet wird wie ein Lipid aus der Literatur. Verlassen Sie sich nicht auf Lipidnamen: In unseren Tests ließ sich die namensbasierte Eingabe nicht immer in unterscheidbare Deskriptoren auflösen, während dasselbe Lipid als SMILES differenzierte Prognosen lieferte. Kennzeichnen Sie jede Struktur weit außerhalb der Trainingschemie als außerhalb der Anwendungsdomäne.
Was bedeutet die Expressions- oder Transfektionszahl?
Es ist ein einheitenloser Modell-Score, bei dem ein höherer Wert besser ist und der dazu dient, Formulierungen gegeneinander zu ordnen. Es ist kein Luciferase-Messwert, kein Anteil transfizierter Zellen und kein Steigerungsfaktor. In unserem Vergleich erzielte MC3 3,56 und ALC-0315 3,81; das bedeutet, dass ALC-0315 höher eingeordnet wird, nicht, dass die Expression um einen bestimmten gemessenen Betrag steigt.
Ersetzt eine In-silico-Pareto-Front eine statistische Versuchsplanung?
Nein. Sie grenzt ein, was die Versuchsplanung abdecken muss. Eine modellbasierte Front sagt Ihnen, welcher Bereich des Zusammensetzungsraums ein geplantes Experiment wert ist, sodass Sie Ihre Läufe auf ein engeres, besser zentriertes Design verwenden können. Die Versuchsplanung, die Replikation und die statistische Analyse der gemessenen Daten müssen für jede Aussage, die Sie verteidigen wollen, weiterhin stattfinden.
Weiterführende Artikel
- Mixture Designs für Formulierungs-DoE: warum Komponenten, die sich zu 100 % summieren, ein faktorielles Design unbrauchbar machen
- Response Surface Methodology Tutorial: das Modell hinter einem Optimum anpassen und interpretieren
- Design Space, NOR und PAR: ICH Q8 erklärt: einen optimierten Bereich in einen verteidigungsfähigen Betriebsbereich überführen
- QbD-Prozessentwicklung: DoE-, RSM- und ML-Workflow: wo ein In-silico-Screening in den gesamten Entwicklungsweg passt
Gerechnet mit CovaSyn
Die Zahlen in diesem Artikel stammen aus unseren Werkzeugen.
- LNP-Formulierung für mRNA: Verkapselung, Größe, N/P.