

Die meisten Prozessentwicklungen laufen als drei getrennte Übungen ab. Jemand screent Faktoren in einer Tabelle, jemand anderes passt Monate später eine Response Surface an, und ein Data Scientist trainiert ein Modell auf den Zeilen, die überlebt haben. Niemand prüft, ob die drei übereinstimmen. Dieser Artikel führt eine Pd-Kreuzkupplung anhand eines einzigen Datensatzes mit 29 Läufen durch alle drei Stufen und zeigt, was die Übereinstimmung zwischen ihnen wert ist.
Der Workflow in einem Satz
Screenen, um herauszufinden, was zählt. Die Überlebenden modellieren, um das Optimum zu finden. Dann den gesamten Datensatz ein zweites Mal mit einer anderen Methode modellieren, um zu sehen, ob die Antwort standhält.
Die drei Stufen sind nicht redundant. Screening ist günstig und beantwortet eine Rangfolgefrage. Response-Surface-Modellierung ist pro Faktor teuer und beantwortet eine Lagefrage. Ein kreuzvalidiertes, nichtlineares Regressionsmodell beantwortet eine Robustheitsfrage: Übersteht das Optimum eine Methode, die keine der polynomialen Annahmen der RSM trifft?
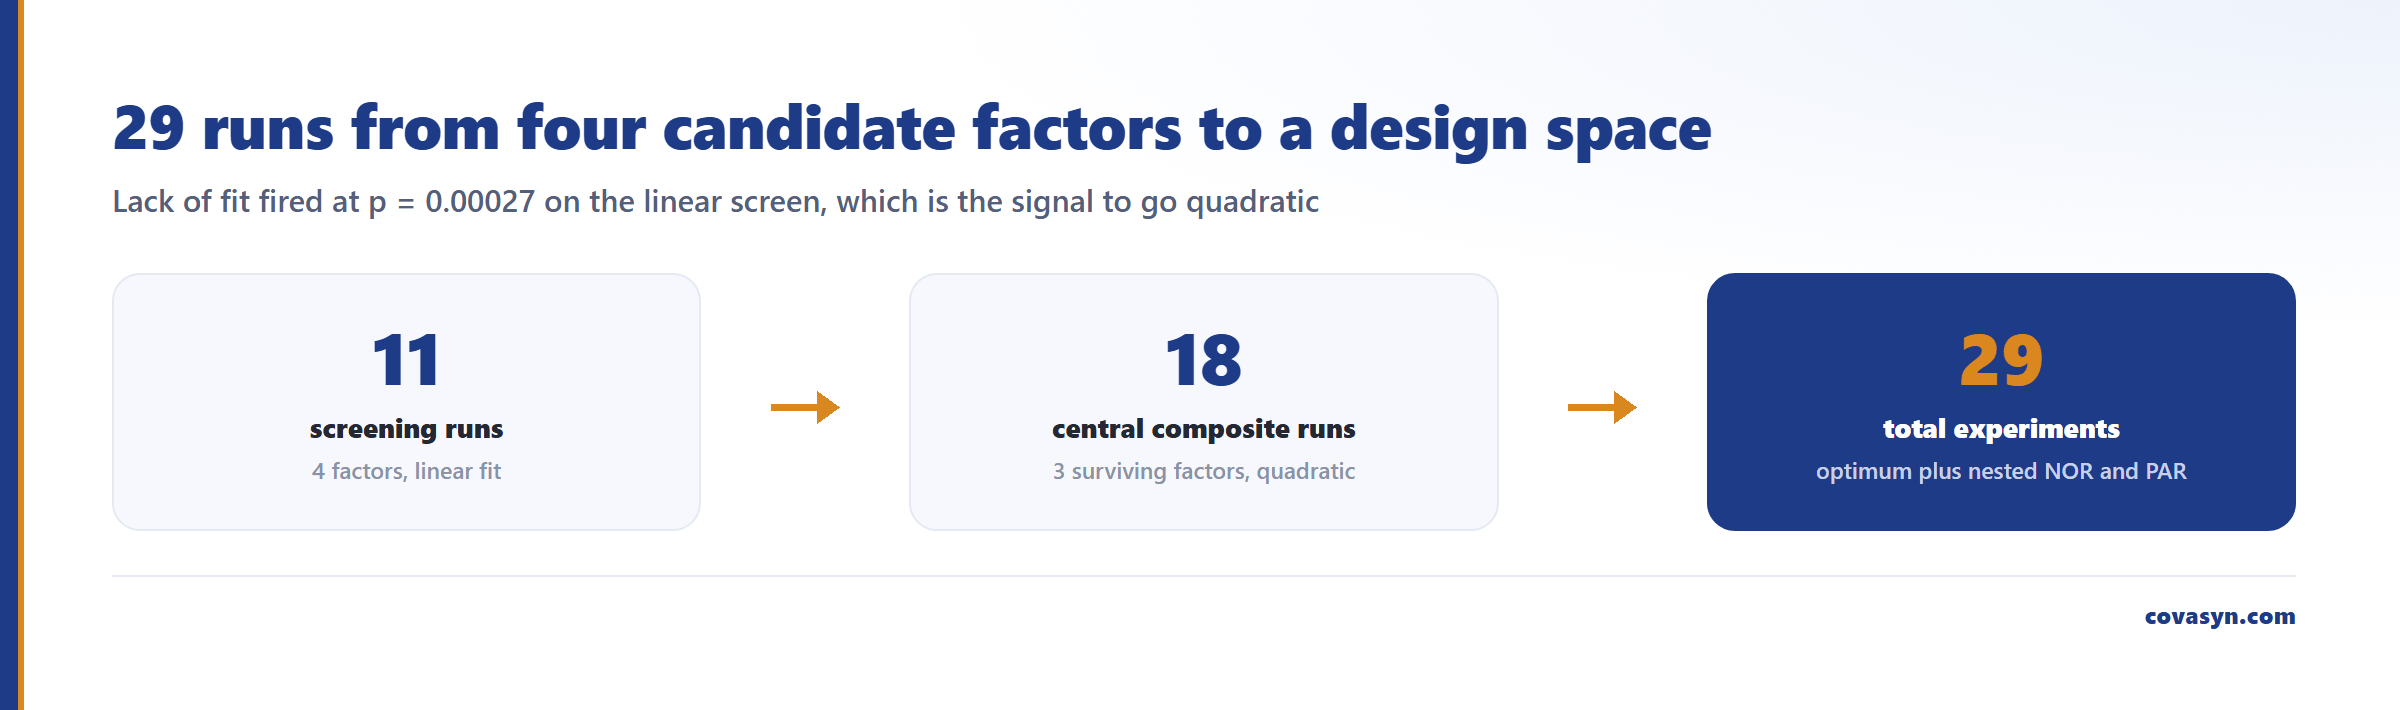
Gesamter experimenteller Aufwand im folgenden Beispiel: 29 Läufe. Das ist die ganze Geschichte von „wir haben vier Kandidatenfaktoren“ bis „hier ist eine Kontrollstrategie mit verschachteltem NOR und PAR“.
Stufe 1: screenen, und das Design entscheiden lassen, wann Schluss ist
Vier Kandidatenfaktoren: Temperatur, Katalysatorbeladung, Reaktionszeit, Base-Äquivalente. Ein Screening-Design mit 11 Läufen, linear angepasst.
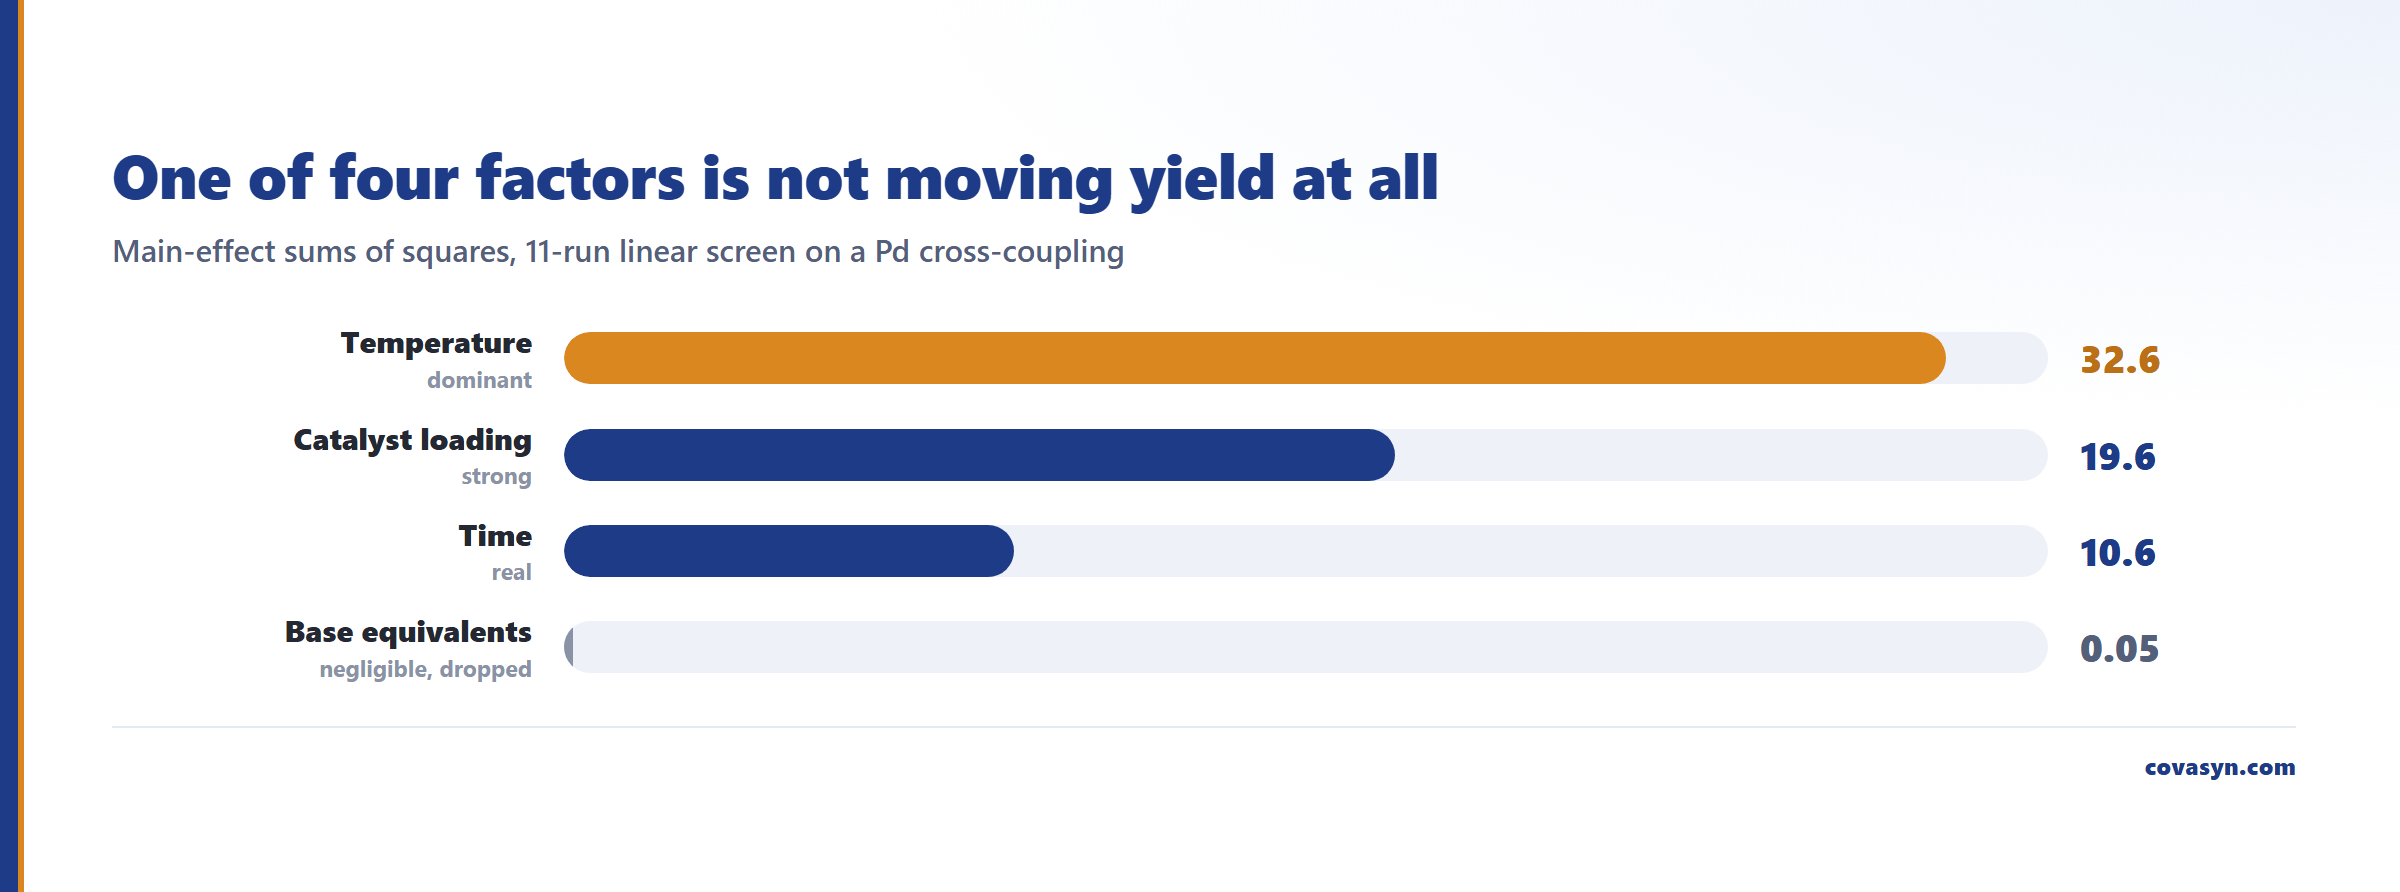
Die Quadratsummen der Haupteffekte kamen wie folgt zurück:
| Faktor | Quadratsumme Haupteffekt | Lesart |
|---|---|---|
| Temperatur | 32,6 | dominant |
| Katalysatorbeladung | 19,6 | stark |
| Zeit | 10,6 | real |
| Base-Äquivalente | 0,05 | vernachlässigbar |
Base-Äquivalente tragen 0,05 bei gegenüber einem Temperatureffekt von 32,6, rund drei Größenordnungen weniger. Dieser Faktor treibt die Ausbeute innerhalb der getesteten Bereiche nicht. Streichen Sie ihn, und Sie haben ein Problem mit vier Faktoren auf drei reduziert, bevor Sie auch nur einen Lauf für eine Response Surface investiert haben. Genau daher kommt die tatsächliche Ersparnis beim DoE: nicht aus dem Screening selbst, sondern daraus, was Ihnen das Screening als Nächstes erspart.
Das zweite Ergebnis zählt mehr als die Rangfolge. Der Lack-of-Fit-Test schlug an bei p = 0,00027. Das lineare Modell kann diese Daten nicht beschreiben. Die Zentrumspunkte liegen deutlich über der Ebene durch die Eckpunkte, das klassische Signal für Krümmung: Irgendwo zwischen den Eckeinstellungen liegt ein inneres Maximum.
Das ist eine Entscheidung, kein Diagramm. Ein signifikanter Lack-of-Fit in der Screening-Stufe bedeutet: mit dem Screening aufhören. Mehr lineare Läufe helfen nicht weiter. Auf ein quadratisches Modell wechseln.
Stufe 2: Response Surface auf den Überlebenden
Drei Faktoren, ein Central-Composite-Design mit 18 Läufen, quadratische Anpassung: R-Quadrat 0,922, alle quadratischen Terme signifikant und negativ.
Negative quadratische Terme bei jedem Faktor sind die Voraussetzung für ein echtes inneres Maximum statt eines Randoptimums. Wäre ein quadratischer Term positiv oder nicht signifikant zurückgekommen, wäre die Fläche ein Sattel oder ein Grat, und das „Optimum“ wäre nur die Ecke Ihres Versuchsraums.
Der stationäre Punkt der Fläche liegt hier:
- 84,7 °C, 1,39 mol-% Katalysator, 11,1 h
- Vorhergesagte Ausbeute 93,63 %, 95-%-Konfidenzintervall 92,98 bis 94,28 %
Zitieren Sie dieses Intervall, wenn jemand fragt, wie sicher Sie sich sind. Es sind rund ± 0,65 Prozentpunkte um die mittlere Antwort, eng genug, um eine Kontrollstrategie darauf aufzubauen, und weit genug, dass Sie nicht über die dritte Nachkommastelle streiten sollten.
Anschließend wurde ein PAR um das Optimum gelegt, bei einem Akzeptanzkriterium von Ausbeute ≥ 92 %. Das ist der Bereich, den Sie in eine ICH-Q8-Design-Space-Diskussion mitnehmen würden.
Aufwand bisher: 11 + 18 = 29 Läufe, und Sie haben ein vertretbares Optimum mit einem Intervall darauf.
Stufe 3: eine zweite Meinung von einer anderen Methode
Jetzt fließen alle 29 Läufe, Screening und CCD zusammen, in ein datengetriebenes Regressionsmodell, bewertet über Kreuzvalidierung auf jeweils zurückgehaltenen Daten. Das ist nicht dieselbe Mathematik wie die RSM, und es setzt keine quadratische Form voraus.
Ergebnisse:
| Antwortgröße | Kreuzvalidiertes Q-Quadrat | Einordnung |
|---|---|---|
| Ausbeute | 0,89 | besteht, für Optimierung nutzbar |
| Reinheit | 0,53 | fällt durch, nur überwachen |
Zwei Dinge sind aus dieser Tabelle mitzunehmen. Erstens: Ausbeute mit Q-Quadrat 0,89 ist ein Modell, gegen das Sie optimieren können. Zweitens: Reinheit mit 0,53 ist es nicht, und die Auswertung sagt das, statt Ihnen eine Zahl zum Steuern in die Hand zu drücken. In diesem Datensatz liegt die Reinheit nahe ihrer Obergrenze mit sehr wenig Varianz, sodass für ein Modell fast nichts zu lernen bleibt. Eine Antwortgröße nahe der Obergrenze mit geringer Varianz ist ein häufiger und ehrlicher Grund für ein schwaches Modell. Die richtige Konsequenz ist, Reinheit als überwachtes Attribut zu behalten und nicht in die Zielfunktion aufzunehmen.
Drei Prüfungen am Ausbeute-Modell:
1. Die Faktor-Rangfolge reproduziert das Screening. Die Merkmalswichtigkeit (Feature Importance) des Regressionsmodells setzte Temperatur auf 0,61, vor Katalysatorbeladung, vor Zeit. Dieselbe Reihenfolge wie die Quadratsummen aus dem Screening, aus einem völlig anderen Schätzer. 2. Das Optimum reproduziert die RSM. Der Sollwert des Regressionsmodells landete bei 85,2 °C, 1,40 mol-%, 10,9 h mit einer vorhergesagten Ausbeute von 93,4 %, gegenüber dem RSM-Optimum von 84,7 °C / 1,39 mol-% / 11,1 h mit 93,63 %. Ein halbes Grad, 0,01 mol-%, 0,2 h Abstand. 3. Die Bereiche verschachteln sich. Das Modell lieferte einen NOR und PAR, die innerhalb des RSM-Design-Space liegen, statt über dessen Rand zu ragen. Eine Kontrollstrategie, bei der das modellbasierte Betriebsband dem RSM-Band widerspricht, ist eine Strategie, die Sie zweimal verteidigen müssen.
Die SPC-Auswertung mit denselben Daten zeigt: Der Prozess ist statistisch unter Kontrolle mit 0,0 % Out-of-Spec-Punkten. Beachten Sie, was das ist und was nicht: Das ist ein Regelkarten-Beleg, kein Fähigkeitsindex. Einen numerischen Cpk gibt es hier nicht, weil keine Spezifikationsgrenzen festgelegt waren, und wir zitieren keinen, der nicht berechnet wurde.
Warum die Übereinstimmung das eigentliche Ergebnis ist
Drei Methoden, ein Datensatz, eine Antwort:
| Stufe | Top-Faktor | Optimum | Vorhergesagte Ausbeute |
|---|---|---|---|
| Screening (11 Läufe) | Temperatur (SS 32,6) | Krümmung erkannt, p = 0,00027 | entfällt |
| RSM (18 Läufe) | entfällt | 84,7 °C / 1,39 mol-% / 11,1 h | 93,63 % (95-%-Intervall 92,98 bis 94,28) |
| Regressionsmodell (alle 29 Läufe) | Temperatur (0,61) | 85,2 °C / 1,40 mol-% / 10,9 h | 93,4 % |
Hätten das RSM-Optimum und das Optimum des Regressionsmodells um zehn Grad auseinandergelegen, hätten Sie etwas Wichtiges gelernt: entweder ist die quadratische Form falsch, oder das Regressionsmodell passt sich an Rauschen an, oder es steckt Struktur in den Daten, die einer der beiden übersieht. Uneinigkeit zwischen Methoden ist eine Diagnose. Übereinstimmung ist das Nächste, was Sie an interner Validierung bekommen, ohne weitere Läufe zu investieren.
Was dieser Workflow nicht verrät
- Das ist keine Bestätigung. Alle drei Stufen lesen dieselben 29 Experimente. Übereinstimmung schließt Methodenartefakte aus; sie schließt keinen systematischen Fehler in den Daten selbst aus. Sie fahren trotzdem Bestätigungschargen beim vorgeschlagenen Sollwert.
- Er extrapoliert nicht. Jeder genannte Bereich liegt innerhalb der experimentellen Hülle. Das Modell sagt nichts Vertretbares über 120 °C, wenn Sie nie über 100 °C gefahren sind.
- Reinheit ist hier nicht modelliert. Q-Quadrat 0,53 bedeutet, dass die Reinheitsfläche nicht charakterisiert ist. Ist Reinheit ein CQA, braucht sie eine eigene Studie mit Läufen, die sie tatsächlich bewegen.
- Kein Fähigkeitsindex. 0,0 % Out-of-Spec ist SPC-Evidenz für Kontrolle. Das ist keine Cpk- oder Ppk-Aussage und kein Validierungsergebnis.
- Dieser Datensatz ist repräsentativ. Die Pd-Kupplungs-Eingaben sind illustrativ und keine konkrete Kundenkampagne. Jede oben genannte Kennzahl (Quadratsummen, Lack-of-Fit-p-Wert, R-Quadrat, Q-Quadrat, Optima und Intervalle) ist echt auf diesen Daten berechnet, keine in eine Folie geschriebene Schätzung.
Häufige Fragen
Wie viele Experimente braucht ein QbD-Prozessentwicklungs-Workflow?
Im obigen durchgerechneten Beispiel brachten 29 Läufe eine Vier-Faktor-Pd-Kupplung von einem ungescreenten Problem zu einem charakterisierten Optimum mit verschachteltem Betriebsbereich: ein Screening-Design mit 11 Läufen, dann ein Central-Composite-Design mit 18 Läufen auf den drei überlebenden Faktoren. Das Screening macht dies bezahlbar, weil das Streichen eines vernachlässigbaren Faktors vor der Response-Surface-Stufe Läufe im teuren Design spart, nicht im günstigen.
Wann sollte man mit dem Screening aufhören und zu einem Response-Surface-Design wechseln?
Wenn der Lack-of-Fit-Test am linearen Screening-Modell signifikant wird. Im Beispiel ergab sich ein Lack-of-Fit von p = 0,00027, was bedeutet, dass die Zentrumspunkte weit über der Ebene durch die Eckläufe lagen. Das ist Krümmung, und keine noch so große Zahl zusätzlicher linearer Läufe löst das. Die vernachlässigbaren Faktoren streichen und zu einem quadratischen Design erweitern.
Ersetzt ein Regressionsmodell das Design of Experiments in der Prozessentwicklung?
Nein. In diesem Beispiel wurde das Regressionsmodell auf den DoE-Läufen trainiert und hätte ohne sie nicht existieren können. Sein Wert lag in der Bestätigung: kreuzvalidiertes Ausbeute-Q-Quadrat 0,89, eine Rangfolge der Faktoren, die die Screening-Reihenfolge mit Temperatur bei 0,61 reproduzierte, und ein Sollwert 0,5 °C vom RSM-Optimum entfernt. Das Regressionsmodell beantwortet, ob die Antwort eine andere Methode übersteht, nicht, ob Sie die Experimente überspringen können.
Was bedeutet ein niedriges Q-Quadrat bei einer Antwortgröße?
Es bedeutet, dass diese Antwortgröße nicht gut genug modelliert ist, um dagegen zu optimieren, und stattdessen überwacht werden sollte. Im durchgerechneten Beispiel lieferte Reinheit ein Q-Quadrat von 0,53, weil sie nahe ihrer Obergrenze mit sehr wenig Lauf-zu-Lauf-Varianz lag, sodass fast kein Signal zum Lernen vorhanden war. Die ehrliche Konsequenz ist, sie aus der Zielfunktion auszuschließen und als überwachtes Attribut zu behalten.
Warum sollte der Betriebsbereich des Regressionsmodells innerhalb des RSM-Design-Space liegen?
Weil eine Kontrollstrategie mit zwei widersprüchlichen akzeptablen Bereichen zweimal verteidigt werden muss. Im Beispiel lagen die NOR- und PAR-Bereiche des Regressionsmodells verschachtelt innerhalb des Response-Surface-Design-Space, sodass die modellbasierte und die RSM-basierte Sicht übereinstimmen, wo der Prozess laufen darf. Hätten sie sich überlappt statt eingebettet zu sein, wäre diese Diskrepanz das Erste, was vor jedem Vorschlag zu klären ist.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- Design-of-Experiments, RSM, Templates.
- Mehrziel-Optimierung, Robustheit, Drift.