

Maßgeschneiderte ionisierbare Lipide sind teuer und langsam herzustellen, und die meisten Screening-Kampagnen verbrauchen einen erheblichen Teil einer kostbaren Charge für Formulierungen, die ohnehin nie in Frage kommen. Ein Mikrofluidik-Screening mit zwölf Lipiden, RiboGreen, DLS und einem zellbasierten Auslesen kostet eine Woche Handarbeit plus mRNA, die Sie nicht zurückbekommen. Die Frage, die es zu beantworten lohnt, bevor Sie eine Pipette anfassen, ist eng gefasst: Welches der Lipide, die ich tatsächlich habe, verdient den nächsten Lauf?
Was „Screening aus SMILES“ tatsächlich bedeutet
Unsere LNP-Auswertung nimmt eine Formulierung als Strukturen plus Verhältnisse entgegen, nicht als Namen. Sie geben das SMILES des ionisierbaren Lipids ein, dazu Helferlipid, Cholesterin, PEG-Lipid, die molaren Verhältnisse und das N/P-Verhältnis. Zurück kommt ein Satz prognostizierter Eigenschaften: Verkapselungseffizienz, Partikelgröße, PDI und ein Expressions-Score.
Das ist aus einem bestimmten Grund wichtig. Eine Namenssuche funktioniert nur für Lipide, die in irgendjemandes Tabelle existieren. Ihr hauseigenes Lipid, das mit dem verzweigten Schwanz, das Sie letzten Monat hergestellt haben, steht in keiner Tabelle. Arbeitet das Modell direkt auf SMILES, geht ein neuartiges Lipid genauso in den Arbeitsablauf ein wie MC3. Einen Sonderweg für „unbekannte Verbindung“ gibt es nicht.
Ein Vorbehalt vorab, und das ist die ehrliche Grenze des gesamten Ansatzes: Das sind Prognosen, trainiert auf publizierten LNP-Datensätzen. Sie dienen der Triage und ordnen Ihre Kandidatenliste, sie ersetzen aber nicht für RiboGreen, DLS oder einen Transfektionsassay.
Die drei Schritte, die ein erstes Screening ersetzen
Schritt 1: die Referenz bewerten
DLin-MC3-DMA ist nach wie vor die Referenz, an der sich die meisten Gruppen orientieren. Bewerten Sie es zuerst, damit jede spätere Zahl einen Vergleichsmaßstab hat.
Für ein MC3-mRNA-LNP ergab die Prognose:
| Eigenschaft | Prognostizierter Wert |
|---|---|
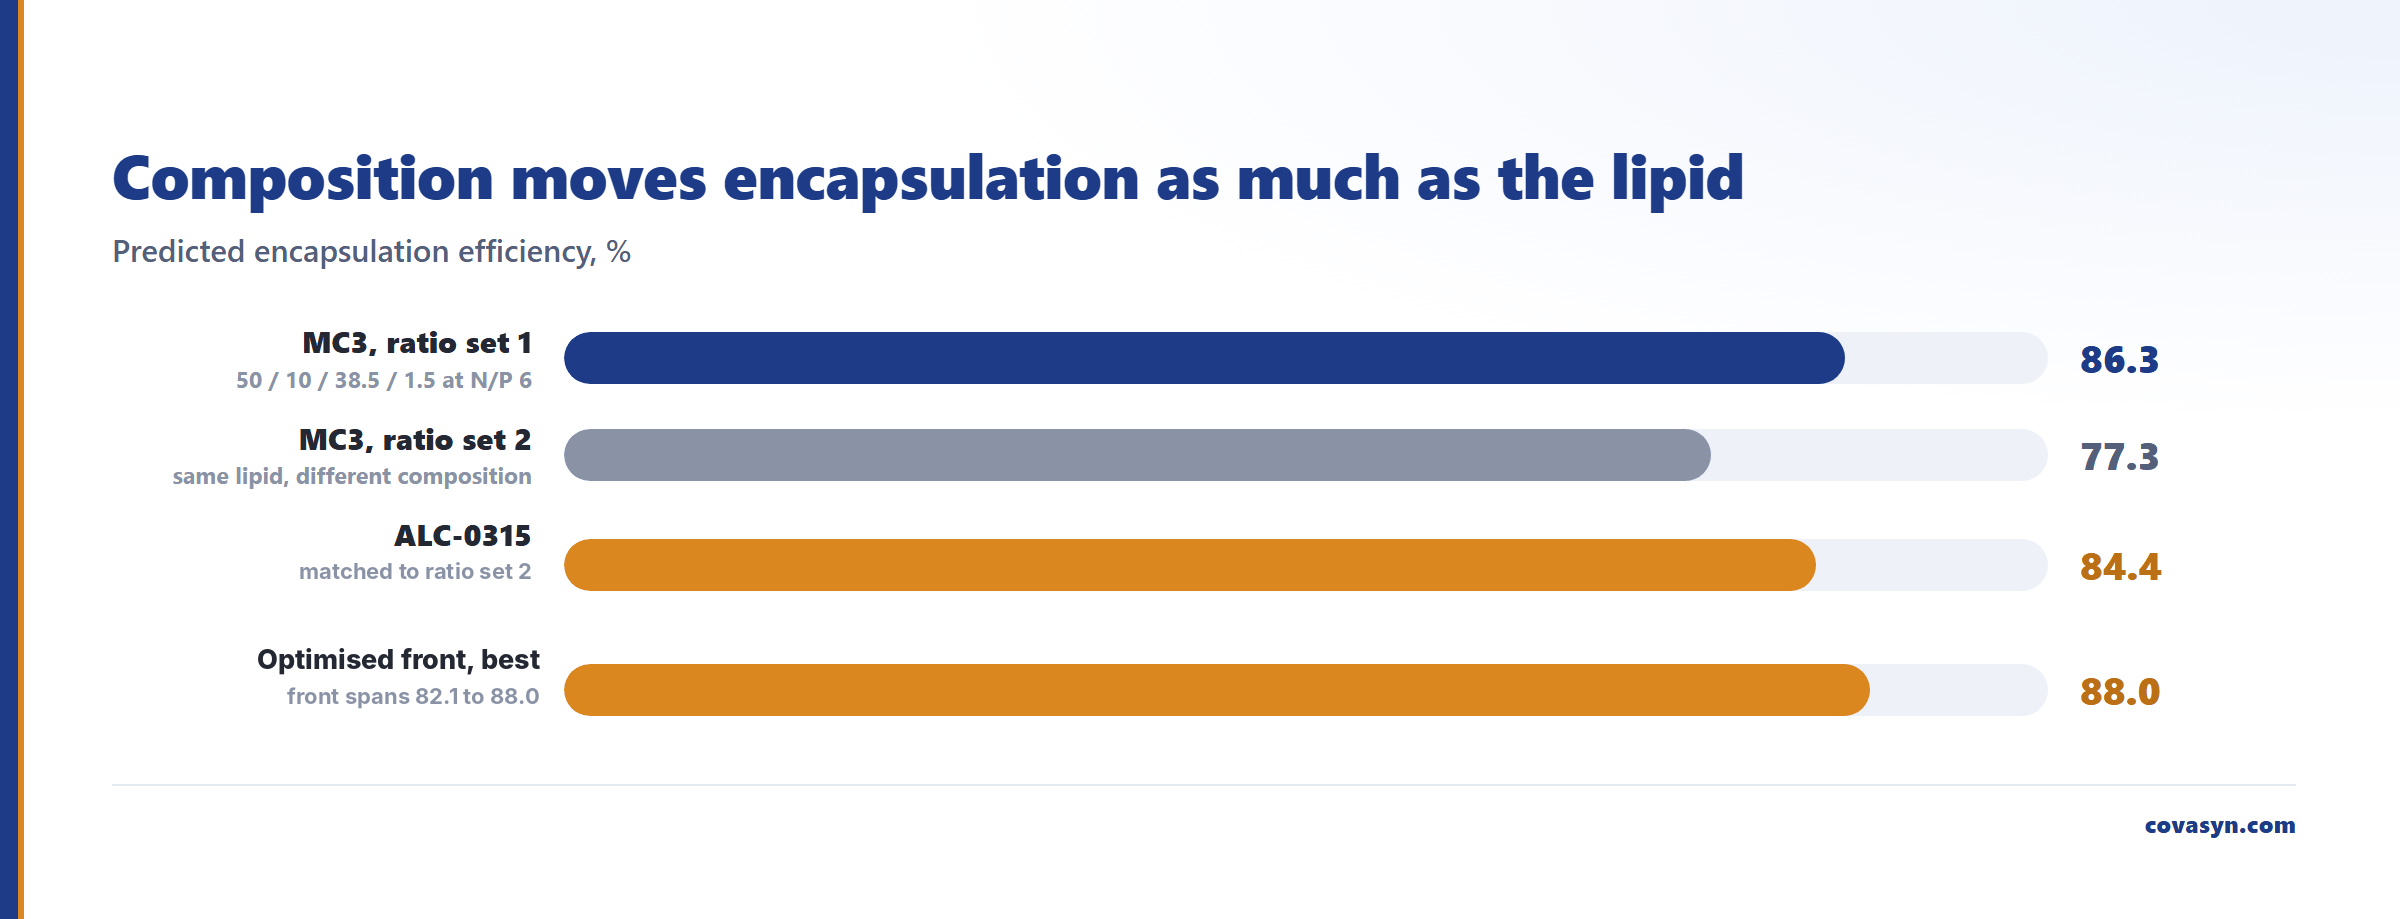
| Verkapselungseffizienz | 86,3 % |
| Partikelgröße | 94,9 nm |
| PDI | 0,150 |
| Expressions-Score (HeLa) | 3,56 |
Dieser Lauf verwendete ein molares Verhältnis von 50 / 10 / 38,5 / 1,5 bei N/P 6.
Aufschlussreich war, dasselbe Lipid zweimal zu bewerten. Eine zweite Prognose auf MC3 mit anderer Zusammensetzung lieferte 77,3 % Verkapselung und 94,4 nm. Gleiches ionisierbares Lipid, andere Verhältnisse, rund neun Prozentpunkte Unterschied in der Verkapselung. Das Modell reagiert auf die Zusammensetzung, nicht nur auf das Lipid. Legen Sie also Ihre Verhältnisse und Ihr N/P fest, bevor Sie Lipide vergleichen, sonst schreiben Sie einen Formulierungseffekt fälschlich der Chemie zu.
Die Expressionszahl braucht ihre eigene Kennzeichnung. Die transfection_*-Ausgaben sind ein einheitenloser prognostizierter Expressions-Score, bei dem ein höherer Wert besser ist. Es ist kein Luciferase-Messwert in relativen Lichteinheiten und trägt keine zelllinienspezifische Einheit. Behandeln Sie ihn als Rangsignal.
Schritt 2: das nächste Lipid durch aktives Lernen wählen lassen
Der erste Impuls ist, ein Raster abzuarbeiten. Besser ist das Experiment, das den größten Erkenntnisgewinn bringt.
Die Vorschlagsfunktion ordnet Kandidaten nach erwartetem Informationsgewinn statt allein nach prognostizierter Leistung. An erster Stelle stand ALC-0315 mit einer prognostizierten Expression von 3,81 und einem erwarteten Informationsgewinn von 10,97. CKK-E12 folgte mit prognostizierten 3,70.
Lesen Sie diese Reihenfolge genau. Es gilt nicht einfach „die höchste prognostizierte Zahl gewinnt“. Der Informationsgewinn bevorzugt Kandidaten, die sowohl vielversprechend sind als auch in einer Region liegen, in der das Modell unsicher ist, weil genau diese Läufe das Modell am meisten weiterbringen. Ein Kandidat, bei dem Sie bereits sicher sind, bringt Ihnen eine Bestätigung, aber keinen Erkenntnisgewinn.
ALC-0315 wurde als Struktur eingegeben, nicht als Name:
CC(CCCCCCCC)OC(=O)CCCCN(CCCCCCCCCCCCCC)CCCCC(=O)OC(C)CCCCCCCCIhr proprietäres Lipid kommt auf dieselbe Weise in dasselbe Feld.
Schritt 3: direkt vergleichen, einschließlich des Teils, der Ihnen nicht gefallen wird
Der direkte Vergleich setzt beide Lipide auf abgeglichene Verhältnisse, sodass die einzige Variable das ionisierbare Lipid ist:
| Kenngröße | MC3 | ALC-0315 | Differenz |
|---|---|---|---|
| Expressions-Score (HeLa) | 3,56 | 3,81 | +7,0 % |
| Verkapselungseffizienz | 77,3 % | 84,4 % | +7,1 Prozentpunkte |
| Partikelgröße | 94 nm | 113 nm | +19 nm |
Die Größenzahl ist diejenige, über die es sich intern zu streiten lohnt. Ein Anstieg um 19 nm ist nicht automatisch ein Nachteil, aber wenn Ihre Spezifikation eine Obergrenze für die Größe vorsieht oder Sie einen biodistributionsbedingten Grund haben, unter 100 nm zu bleiben, dann kommen die Verkapselungs- und Expressionsgewinne mit einem Preis, den Sie jetzt abwägen müssen. Eine Auswertung, die nur die zwei verbesserten Metriken meldet, hilft Ihnen nicht.
Warum diese Reihenfolge Material spart
Die Abfolge ist bewusst gewählt: Referenz, dann der informativste Kandidat, dann die Bestätigung. Das ist dieselbe Logik wie bei einer sequenziellen statistischen Versuchsplanung. Sie versuchen nicht, den gesamten Lipidraum in silico zu kartieren. Sie versuchen zu entscheiden, welche zwei oder drei Lipide diesen Monat Laborzeit bekommen.
Eine praktische Form dafür:
- Bewerten Sie jedes physisch vorhandene Lipid, plus die Literaturreferenzen, die Sie schlagen wollen, in einem Durchgang.
- Streichen Sie alles, was eine harte Spezifikation eindeutig verfehlt, zum Beispiel eine prognostizierte Größe weit außerhalb Ihres Zielfensters.
- Lassen Sie die verbleibenden Kandidaten nach Informationsgewinn ordnen, um das nächste Experiment in einer Rangfolge zu erhalten.
- Nehmen Sie die besten zwei oder drei mit ins Labor, nicht die besten zehn.
Für die gleichzeitige Optimierung mehrerer Zielgrößen wird der Raum aus ionisierbarem Lipid, Helferlipid, PEG-Lipid und N/P durchsucht; das Ergebnis ist eine Pareto-Front, die alle Nebenbedingungen erfüllt. Im Lauf, der diesem Artikel zugrunde liegt, reichte die Verkapselung über diese Front von 82,1 % bis 88,0 % gegenüber einem MC3-Ausgangswert von 77,3 %. Ein ehrlicher Hinweis: Im selben Lauf kam die prognostizierte Transfektion als 0,0 zurück, offenkundig fehlerhaft, weshalb wir diesen Lauf nur für die Verkapselung genutzt und die Expressionswerte aus Einzelprognose und Vergleich genommen haben.
Ehrliche Grenzen
Was das nicht sagt:
- Keine Aussage zu In-vivo-Verhalten. Der Expressions-Score ist ein Rangsignal auf Ebene der Zellkultur. Er sagt nichts über Lebertropismus, die Effizienz der endosomalen Freisetzung in einem bestimmten Gewebe oder das Dosis-Wirkungs-Verhalten im Tier.
- Kein scheinbarer pKa, kein Ionisierungsprofil. Die Modelle prognostizieren Formulierungsergebnisse, nicht das Titrationsverhalten des Lipids, also oft genau die Eigenschaft, auf die Sie eigentlich hin entwickeln.
- Namensauflösung ist nicht zuverlässig. SM-102 ließ sich in unseren Tests als Name nicht in unterscheidbare Deskriptoren auflösen, weshalb wir nirgends SM-102-Zahlen zitieren. Geben Sie Strukturen an.
- Keine Merkmalszuordnung. Wir machen keine SHAP-artigen Aussagen darüber, welche Teilstruktur eine Prognose bestimmt hat.
- Anwendungsdomäne. Prognosen für Lipidchemien weit außerhalb der publizierten Trainingsverteilung, insbesondere für neuartige Kopfgruppen, sind als schwache Anhaltspunkte zu behandeln und früh experimentell zu bestätigen.
- Stabilität ist nicht abgedeckt. Die Verkapselung zum Zeitpunkt null sagt nichts über die Stabilität nach vier Wochen bei 5 °C, und nichts hier sagt etwas über Lipidhydrolyse oder mRNA-Integrität über die Zeit.
Häufige Fragen
Was ist Screening ionisierbarer Lipide?
Beim Screening ionisierbarer Lipide werden Kandidaten für ein mRNA- oder siRNA-Lipidnanopartikel in eine Rangfolge gebracht, bevor Material in Formulierungsarbeit gebunden wird. Traditionell bedeutet das, jeden Kandidaten per Mikrofluidik-Mischung zu formulieren und Verkapselung, Größe, PDI und Transfektion zu messen. Ein In-silico-Screening ordnet dieselben Kandidaten zunächst anhand ihrer chemischen Strukturen, sodass nur die wenigen besten ins Labor gehen.
Kann ich ein proprietäres Lipid screenen, das in keiner Datenbank steht?
Ja, wenn die Auswertung direkt auf Strukturen arbeitet. Unsere LNP-Auswertung nimmt das ionisierbare Lipid als SMILES entgegen, zusammen mit Helferlipid, Cholesterin, PEG-Lipid, molaren Verhältnissen und N/P-Verhältnis, sodass ein unveröffentlichtes hauseigenes Lipid genau wie ein Referenzlipid behandelt wird. Namensbasierte Suchen scheitern hier: In unseren Tests ließ sich SM-102 als Name nicht in unterscheidbare Deskriptoren auflösen, weshalb Strukturen die unterstützte Eingabe sind.
Wie schneidet ALC-0315 im Vergleich zu MC3 in der Prognose ab?
In einem Vergleichslauf mit abgeglichenen Verhältnissen prognostizierte ALC-0315 höher als DLin-MC3-DMA, sowohl bei der Verkapselungseffizienz, 84,4 % gegenüber 77,3 %, als auch beim Expressions-Score, 3,81 gegenüber 3,56, ein relativer Gewinn von 7,0 %. Die Partikelgröße stieg von 94 nm auf 113 nm. Das sind Modellprognosen für die Triage, keine gemessenen Werte, und der Größenanstieg kann für Ihre Spezifikation relevant sein.
Was ist der erwartete Informationsgewinn, und warum nicht einfach die höchste Prognose wählen?
Der erwartete Informationsgewinn bewertet, wie stark ein vorgeschlagenes Experiment die Unsicherheit des Modells verringern würde, nicht nur, wie gut das Ergebnis aussieht. In unserem Vorschlagslauf lag ALC-0315 vorn mit einer prognostizierten Expression von 3,81 und einem Informationsgewinn von 10,97, vor CKK-E12 mit 3,70. Nur den sichersten Kandidaten zu testen bestätigt, was Sie ohnehin annehmen, und bringt dem Modell kaum etwas bei.
Wie genau sind LNP-Eigenschaftsprognosen?
Genau genug, um Kandidaten zu ordnen, nicht genau genug, um eine Charge freizugeben. Die Modelle sind auf publizierten LNP-Formulierungsdaten trainiert, sodass Prognosen für Chemien nahe dieser Verteilung vertrauenswürdiger sind als für neuartige Kopfgruppen. Die prognostizierte Verkapselung desselben Lipids verschob sich von 86,3 % auf 77,3 %, als sich die Zusammensetzung änderte. Halten Sie also Verhältnisse und N/P konstant, wenn Sie Lipide vergleichen.
Ändert die Formulierungszusammensetzung die Prognose, oder nur das Lipid?
Die Zusammensetzung ändert sie erheblich. Zwei Prognosen auf demselben MC3-Lipid bei unterschiedlichen molaren Verhältnissen lieferten 86,3 % und 77,3 % Verkapselung. Das ist beabsichtigt, denn Verhältnisse und N/P beeinflussen die Verkapselung tatsächlich. Es bedeutet aber, dass ein Vergleich zweier Lipide nur bei abgeglichener Zusammensetzung aussagekräftig ist. Nutzen Sie dafür den abgeglichenen Vergleich statt zweier getrennter Einzelprognosen.
Weiterführende Artikel
Gerechnet mit CovaSyn
Die Zahlen in diesem Artikel stammen aus unseren Werkzeugen.
- LNP-Formulierung für mRNA: Verkapselung, Größe, N/P.