

Das Screening hat Ihnen gesagt, welche Faktoren zählen. Es hat Ihnen nicht gesagt, worauf Sie sie einstellen sollen. Response Surface Methodology (RSM) ist die zweite Hälfte der Aufgabe: ein gekrümmtes Modell über die verbliebenen Faktoren anpassen, das Optimum finden und einen Betriebsbereich darum legen, der die normale Prozessstreuung übersteht.
Dieser Artikel geht die Sequenz an einer dreifaktoriellen katalytischen Stufe durch. Jede Zahl stammt unverändert aus der Versuchsplanungs-Auswertung von CovaSyn; der Vorbehalt zur Herkunft dieser Zahlen steht im Abschnitt zu den ehrlichen Grenzen.
Die fünf Schritte, in Reihenfolge
1. Ein Design bauen, das Krümmung schätzen kann. 2. Es ausführen und das quadratische Modell anpassen. 3. Die Residuen prüfen, bevor Sie dem Modell glauben. 4. Das Optimum lokalisieren und ein Intervall darauf legen. 5. Aus dem Punkt eine Region machen.
Schritte 3 und 5 sind die, die übersprungen werden. Schritt 3 ist der Punkt, an dem Sie merken, dass das Modell lügt; Schritt 5 ist der Punkt mit dem Wert für die Einreichung.
Schritt 1: ein Design, das Krümmung sehen kann
Ein zweistufiges Screening-Design kann keinen quadratischen Term anpassen; Sie brauchen mindestens drei Stufen pro Faktor. Dieses Beispiel verwendet ein Central Composite Design (CCD) auf:
- Temperatur: 70 bis 110 °C
- Katalysatorbeladung: 1 bis 6 mol-%
- Zeit: 4 bis 14 h
Das Central Composite Design mit 4 Zentrumspunkten umfasst 18 Läufe: 8 faktorielle Eckpunkte, 6 axiale (Stern-)Punkte, 4 Zentrumspunkte, mit einem axialen Abstand alpha = 2,236. Rotierbar ist das Design damit nicht: ein rotierbares CCD mit 3 Faktoren hätte alpha = 8^(1/4) ≈ 1,682.
Zwei praktische Hinweise. Die 4 replizierten Zentrumspunkte liefern den reinen Fehler, und der reine Fehler ist das, was Ihnen später den Lack-of-Fit-Test ermöglicht. Kürzen Sie sie nicht, um Läufe zu sparen. Und prüfen Sie die axialen Punkte zuerst in realen Einheiten: bei alpha = 2,236 liegen sie außerhalb des angegebenen Bereichs, was für Temperatur unproblematisch (rund 45 bis 135 °C), für einen Faktor mit einer harten Untergrenze bei null aber fatal ist. Genau das betrifft hier die Katalysatorbeladung: Mitte 3,5 mol-%, halbe Spanne 2,5 mol-%, der untere Axialpunkt läge also bei 3,5 - 2,236 × 2,5 ≈ -2,1 mol-%, und auch mit dem rotierbaren alpha = 1,682 noch bei rund -0,7 mol-%. Wenn Ihre Axialpunkte negativ zurückkommen, verwenden Sie stattdessen Box-Behnken oder ein flächenzentriertes CCD (alpha = 1).
Schritt 2: das quadratische Modell anpassen
Mit den 18 Antworten in der Hand wurde das vollständige quadratische Modell angepasst: 3 lineare, 3 quadratische und 3 Zweifaktor-Interaktionsterme plus Achsenabschnitt:
| Kennzahl | Wert |
|---|---|
| R² | 0,9988 |
| Adjustiertes R² | 0,9974 |
| Signifikanz der Terme | alle Terme p < 0,0001 |
| Modellform | vollständig quadratisch, 3 Faktoren |
Lesen Sie diese beiden R²-Werte immer als Paar. R² steigt nur, wenn Sie Terme hinzufügen; das adjustierte R² bestraft Terme, die ihren Platz nicht verdienen. Hier beträgt die Lücke 0,0014, das Modell ist also nicht aufgebläht. Eine große Lücke, etwa R² 0,98 gegen adjustiert 0,89, bedeutet, dass Sie mit Interaktionstermen Rauschen anpassen, und Sie sollten die nicht signifikanten Terme streichen und das Modell neu anpassen.
Ein R² von 0,9988 ist nach Laborstandard hoch. Bei echten Assay-Daten mit 2 bis 3 Prozent Wiederholpräzision erwarten Sie 0,90 bis 0,97, und seien Sie misstrauisch bei allem über 0,999, das Sie nicht selbst simuliert haben.
Schritt 3: die Residuen prüfen, bevor Sie irgendetwas davon glauben
Das trennt ein Modell, das Sie verteidigen können, von einer Zahl, die Sie aus einem Bericht abgeschrieben haben. Die Residuendiagnostik lieferte für dieselbe Anpassung:
- Shapiro-Wilk p = 0,036 auf den Residuen. Unter 0,05, die Normalverteilungsannahme wird also auf dem 5-Prozent-Niveau formal verworfen.
- Cook-Distanz 0,277 bei Lauf 9, als einflussreichster Lauf markiert.
Keins von beiden entkräftet das Modell, und keins von beiden sollte ignoriert werden.
Shapiro-Wilk p = 0,036 bei n = 18.
Normalverteilungstests an 18 Residuen haben eine geringe Teststärke; ein grenzwertiger p-Wert ist also schwache Evidenz in beide Richtungen. Er weist meist auf ein bis zwei Ausreißer-Läufe hin, nicht auf eine echt schiefe Fehlerverteilung. Tragen Sie die Residuen gegen die angepassten Werte auf: eine Trichterform bedeutet nicht konstante Varianz, ein echtes Problem, das üblicherweise mit einer Log- oder Wurzeltransformation der Antwort behoben wird. Einen grenzwertigen Shapiro-Wilk-p-Wert bei sauberem Residuenplot notieren Sie und gehen weiter.
Cook-Distanz 0,277 bei Lauf 9.
Die Cook-Distanz misst, wie stark sich die angepasste Fläche verschiebt, wenn Sie diesen Lauf entfernen. Lauf 9 ist ein axialer Punkt, und axiale Punkte haben konstruktionsbedingt eine hohe Hebelwirkung (Leverage): Am weitesten vom Zentrum entfernt, ziehen sie am stärksten an den quadratischen Termen. Ein gängiger Schwellenwert ist 4/n, hier 0,222, sodass 0,277 darüberliegt, aber nicht dramatisch. Löschen Sie den Lauf nicht. Gehen Sie zurück ins Laborjournal und fragen Sie, ob an ihm etwas Ungewöhnliches war: eine andere Reagenzcharge, ein manuell gehaltenes Temperaturplateau, eine späte Probe. War nichts auffällig, behalten Sie ihn und sagen Sie das auch so.
Löschen Sie nie einen Lauf, weil er statistisch unbequem ist, nur bei einer dokumentierten physikalischen Ursache. Passen Sie das Modell zusätzlich ohne ihn an und berichten Sie beide Anpassungen.
Schritt 4: das Optimum, mit Fehlerbalken
Die Optimumsuche auf der angepassten Fläche lieferte, innerhalb der Design-Grenzen:
- Temperatur 91,2 °C
- Katalysator 3,76 mol-%
- Zeit 9,7 h
- Vorhergesagte Ausbeute 93,5 Prozent
Die Vorhersage an dieser Einstellung ergab:
| Intervall | Bereich |
|---|---|
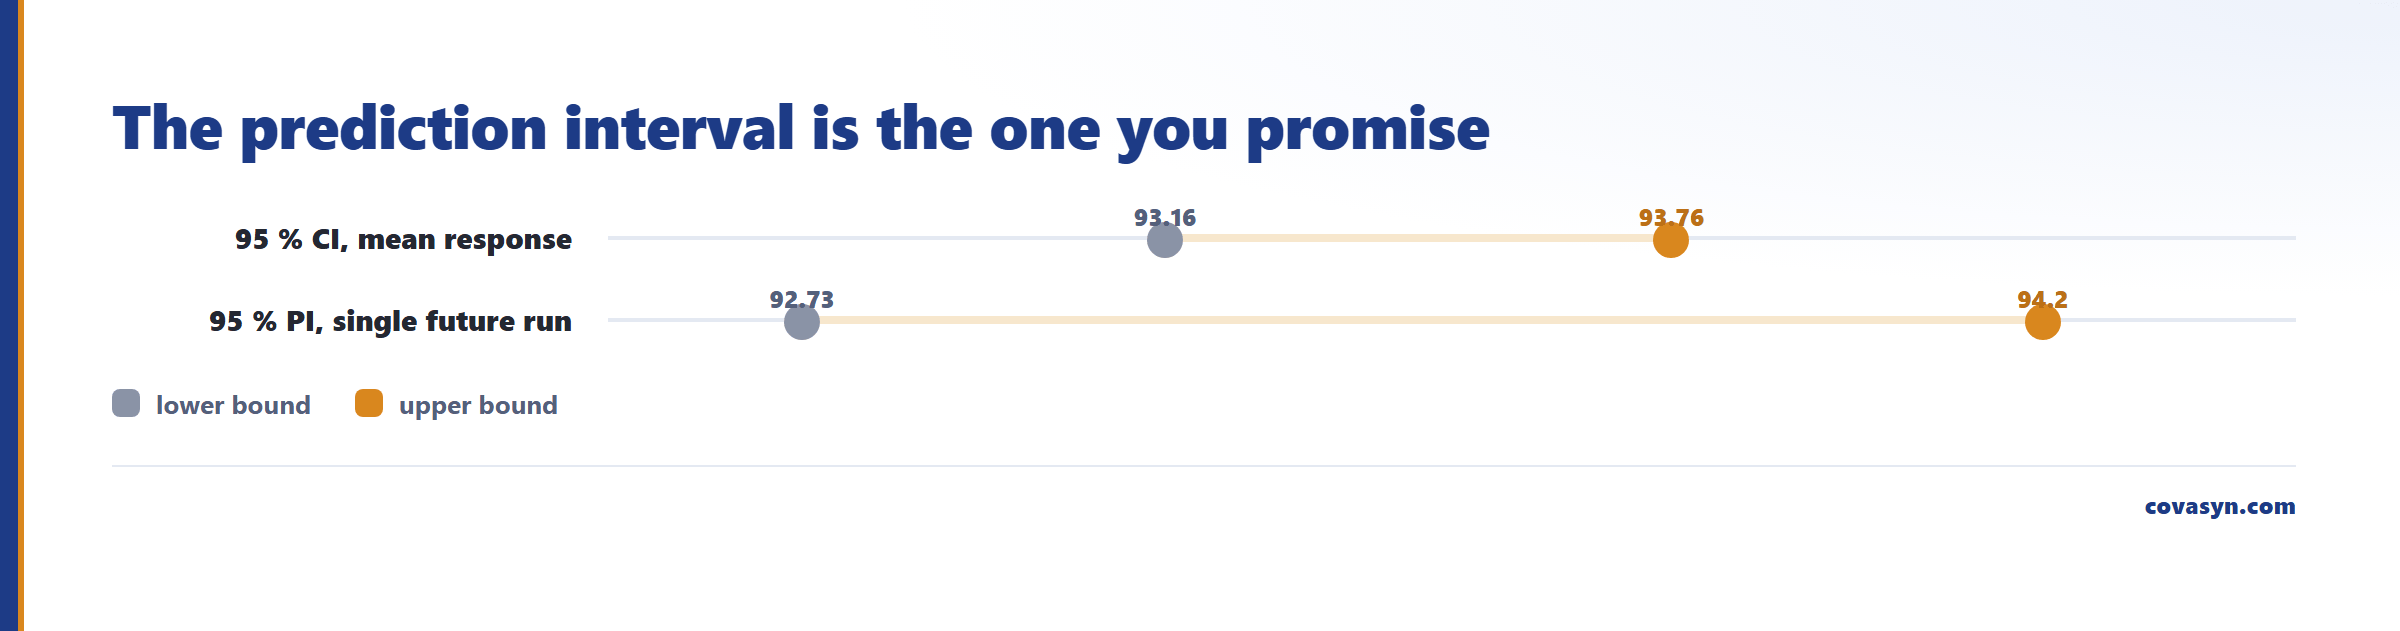
| 95-Prozent-Konfidenzintervall (mittlere Antwort) | 93,16 bis 93,76 Prozent |
| 95-Prozent-Prognoseintervall (einzelner künftiger Lauf) | 92,73 bis 94,20 Prozent |
Diese Unterscheidung wird häufig verwechselt. Das Konfidenzintervall gibt an, wo die wahre durchschnittliche Ausbeute bei dieser Einstellung liegt. Das Prognoseintervall gibt an, wo Ihre nächste einzelne Charge landet; es ist immer breiter, weil es zusätzlich zur Parameterunsicherheit das Lauf-zu-Lauf-Rauschen trägt. Einem Kollegen eine Ausbeute für einen Bestätigungslauf zu versprechen bedeutet, 92,73 bis 94,20 zu nennen, nicht das Konfidenzintervall.
Beachten Sie auch, dass das Optimum bei 91,2 °C gut innerhalb des Bereichs von 70 bis 110 °C liegt. Ein Optimum, das auf einer Grenze landet, ist kein Optimum; es bedeutet, dass der Bereich zu früh beschnitten wurde und die Fläche noch weiter ansteigt. Erweitern Sie den Bereich und messen Sie neu.
Schritt 5: vom Punkt zum Design Space
Ein einzelner Sollwert ist kein fertigungsfähiger Prozess. Die Design-Space-Berechnung propagiert das Modell samt Unsicherheit durch 10.000 Monte-Carlo-Stichproben und liefert die Region, in der die Antwort innerhalb der Spezifikation bleibt.
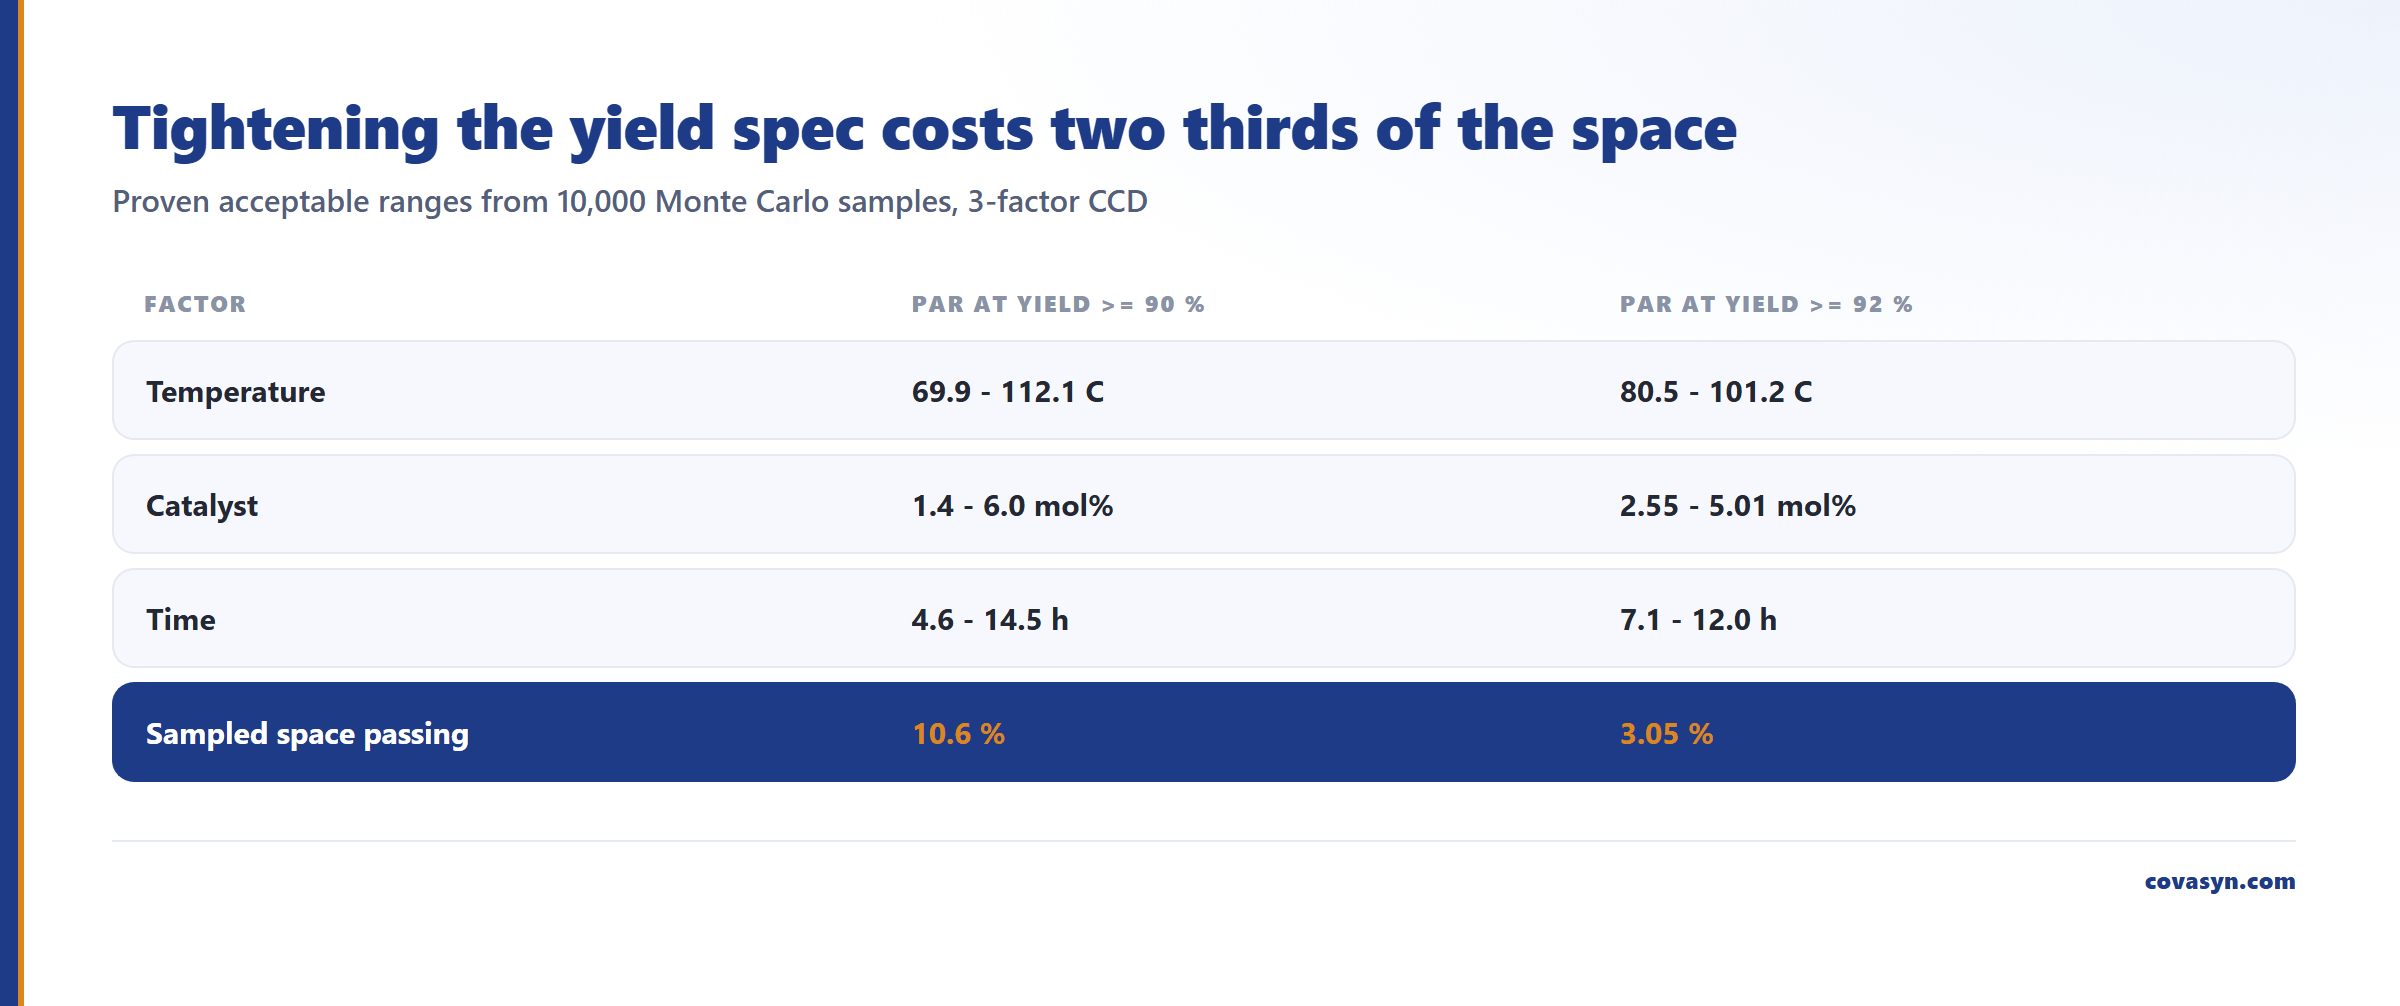
Bei einer Spezifikation von Ausbeute ≥ 90 Prozent:
| Faktor | Nachgewiesener akzeptabler Bereich |
|---|---|
| Temperatur | 69,9 bis 112,1 °C |
| Katalysator | 1,4 bis 6,0 mol-% |
| Zeit | 4,6 bis 14,5 h |
| Anteil des abgetasteten Raums, der besteht | 10,6 Prozent |
Verschärfen Sie die Spezifikation auf ≥ 92 Prozent, und das Fenster schrumpft auf 80,5 bis 101,2 °C, 2,55 bis 5,01 mol-%, 7,1 bis 12,0 h, mit nur noch 3,05 Prozent des abgetasteten Raums, der besteht.
Dieses Zahlenpaar zeigt, was die Spezifikation kostet. Der Wechsel von 90 auf 92 Prozent Ausbeute kostet rund zwei Drittel Ihres Betriebsspielraums und schrumpft das Temperaturfenster von 42 auf 21 Grad. Führen Sie dieses Gespräch mit dem Prozessverantwortlichen, bevor die Grenze in eine Kontrollstrategie eingeht, nicht danach.
Was RSM nicht verrät
- Das Modell gilt nur innerhalb der Design-Region. Ein zwischen 70 und 110 °C angepasstes quadratisches Modell sagt nichts über 130 °C aus. Polynomiale Extrapolation ist nicht nur unsicher, sie liegt oft mit scheinbarer Sicherheit in die falsche Richtung daneben.
- Ein hohes R² ist kein korrektes Modell. Ein quadratisches Modell kann eine Sigmoidfunktion über ein enges Fenster gut anpassen und knapp außerhalb davon deutlich versagen. R² misst die Anpassung an die durchgeführten Läufe, nicht den Mechanismus.
- Das Design-Space-Ergebnis ist modellbasiert, nicht gemessen. Die Monte-Carlo-Stichproben propagieren das angepasste Modell. Sie können nichts von einem Phasenübergang, einer Löslichkeitsgrenze oder einer Katalysatordeaktivierung wissen, die das Design nie abgetastet hat. Randbestätigungsläufe sind nicht optional.
- Dieses Beispiel ist teilweise simuliert. Das 18-Lauf-CCD ist ein echtes Design, und jede genannte Kennzahl (R², Optimum, Intervalle, Design-Space-Bereiche, Diagnostik) ist eine echte Berechnung unserer Auswertung. Die zugrunde liegenden Lauf-Ausbeuten wurden aus einer quadratischen Fläche mit Rauschen simuliert, als Ersatz für Labormessungen. Deshalb ist das R² ungewöhnlich hoch. Betrachten Sie dies als Demonstration des Workflows, nicht als Benchmark der erreichbaren Ausbeute.
- Das ist Entscheidungsunterstützung, keine Einreichung. Die Ergebnisse unserer Auswertung helfen Ihnen zu entwerfen, zu analysieren und zu argumentieren. Sie ersetzen keine Laborbestätigung, kein validiertes Statistikpaket und keine eigene regulatorische Prüfung.
Häufige Fragen
Was ist Response Surface Methodology?
Response Surface Methodology ist ein Design-of-Experiments-Ansatz zur Modellierung einer gekrümmten Beziehung zwischen Prozessfaktoren und einer Antwortgröße. Sie führen ein dreistufiges Design wie ein Central Composite oder Box-Behnken durch, passen ein quadratisches Modell mit linearen, quadratischen und Interaktionstermen an und nutzen dieses Modell dann, um ein Optimum zu lokalisieren und eine Betriebsregion zu definieren. Sie folgt auf das Screening, das identifiziert, welche Faktoren zählen.
Wie viele Läufe braucht eine Response-Surface-Studie?
Ein vollständiges quadratisches Modell mit 3 Faktoren hat 10 Parameter, Sie brauchen also mehr als 10 Läufe plus Replikate für den reinen Fehler. Ein 3-Faktor-Central-Composite-Design mit 4 Zentrumspunkten umfasst 18 Läufe: 8 faktorielle Eckpunkte, 6 axiale Punkte und 4 Zentrumspunkte. Box-Behnken braucht 16 bei derselben Zentrumsreplikation. Die Laufzahlen wachsen jenseits von 4 Faktoren schnell.
Was ist ein gutes R² für ein Response-Surface-Modell?
Betrachten Sie R² und adjustiertes R² zusammen statt R² allein. Im Beispiel dieses Artikels ergab die Anpassung R² 0,9988 mit adjustiertem R² 0,9974, eine Lücke von 0,0014, was bedeutet, dass kein Term die Anpassung aufgebläht hat. Bei echten Assay-Daten mit wenigen Prozent Wiederholpräzision ist 0,90 bis 0,97 ein realistisches Ziel. Eine große Lücke zwischen R² und adjustiertem R² bedeutet, dass Sie Rauschen anpassen.
Was ist der Unterschied zwischen einem Konfidenzintervall und einem Prognoseintervall in der RSM?
Das Konfidenzintervall deckt die wahre mittlere Antwort bei einem Sollwert ab; das Prognoseintervall deckt einen einzelnen künftigen Lauf ab und ist immer breiter, weil es Lauf-zu-Lauf-Rauschen hinzufügt. Am Optimum in diesem Beispiel ergab sich ein 95-Prozent-Konfidenzintervall von 93,16 bis 93,76 Prozent und ein Prognoseintervall von 92,73 bis 94,20 Prozent. Zitieren Sie das Prognoseintervall für eine Bestätigungscharge.
Was zeigt die Cook-Distanz in einem DoE-Modell an?
Die Cook-Distanz misst, wie stark sich die angepasste Fläche verschieben würde, wenn ein Lauf entfernt würde. Die Residuendiagnostik markierte Lauf 9 mit einer Cook-Distanz von 0,277 gegenüber einen gängigen 4/n-Schwellenwert von 0,222 bei 18 Läufen. In einem Central-Composite-Design landen hohe Werte oft auf axialen Punkten, weil sie die höchste Hebelwirkung haben. Untersuchen Sie den Lauf physikalisch; löschen Sie ihn nicht, weil er statistisch unbequem ist.
Sollte ich mir Sorgen machen, wenn ein Normalverteilungstest auf meinen Residuen fehlschlägt?
Ein grenzwertiges Ergebnis verdient einen Blick, keine Panik. Shapiro-Wilk lieferte hier p = 0,036 auf den 18 Residuen und verwarf die Normalverteilung formal auf dem 5-Prozent-Niveau, aber der Test hat bei dieser Stichprobengröße eine geringe Teststärke. Tragen Sie zuerst die Residuen gegen die angepassten Werte auf: eine Trichterform deutet auf nicht konstante Varianz hin und verlangt eine Transformation der Antwort, während ein sauberer Plot mit einem Ausreißer meist auf einen einzelnen ungewöhnlichen Lauf hinweist.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- Design-of-Experiments, RSM, Templates.