

Jedes generative Modell liefert bis zum Mittag zehntausend Moleküle. Der Engpass war nie die Generierung. Er liegt darin, zu entscheiden, welche drei von diesen zehntausend eine Chemikerwoche wert sind, und begründen zu können, warum, einschließlich der Frage, welchen der eigenen Vorhersagen nicht zu trauen ist.
Dieser Artikel begleitet ein designtes Molekül von Anfang bis Ende: Generierung, Drug-Likeness, ADMET- und Toxizitätsscreening, dann eine Bindungsprüfung. Jede Zahl unten stammt unverändert aus einer Auswertung von CovaSyn, und die Out-of-Domain-Flags werden gezeigt statt versteckt, denn genau diese Flags machen aus einem Score eine Entscheidung.
Generierung ist billig, Filterung ist teuer
Ein genetischer Algorithmus über ein Seed-Gerüst, ein VAE, ein Diffusionsmodell über 3D-Taschen: alle erzeugen gültige SMILES zu praktisch null Grenzkosten. Was sie nicht erzeugen, ist ein Grund zur Überzeugung. Die Kosten liegen weiter unten: Ein Syntheseversuch kostet Tage Chemikerzeit, ein In-vitro-hERG-Patch-Clamp oder Ames-Test kostet reales Geld pro Verbindung, und ein falsch negatives Ergebnis, das In-vivo erreicht, ist die teure Art von Fehler.
Die eigentlich nützliche Frage an ein generatives Verfahren lautet daher nicht „kann es Moleküle erfinden“, sondern „was lehnt es ab, und auf welcher Grundlage“. Ein Filterstapel, der alles durchlässt, ist Dekoration.
Die Filterreihenfolge, die zählt
Filter sollten nach Kosten und nach Entscheidungskraft geordnet laufen, die günstigsten zuerst. In der Praxis bedeutet das:
| Stufe | Frage | Kosten |
|---|---|---|
| 1. Validität | Ist das ein reales, parsierbares, standardisierbares Molekül? | sehr gering |
| 2. Eigenschaftsfenster | MW, logP, QED, synthetische Zugänglichkeit | sehr gering |
| 3. Störsubstrukturen | PAINS, Brenk, strukturelle Alerts | sehr gering |
| 4. Sicherheit und ADMET | hERG, Ames, DILI, CYP, Permeabilität | gering |
| 5. Applicability Domain | Darf das Modell hier überhaupt eine Meinung haben? | gering |
| 6. Target-Hypothese | Bindet es plausibel? | deutlich höher |
Stufe 5 überspringen die meisten Pipelines, und genau sie verändert, was mit Stufe 4 und 6 geschieht.
Durchgerechnetes Beispiel: ein designtes Analogon, ganz durchlaufen
Das Molekül unten wurde designt, nicht kuratiert. Das generative Design ging vom Sotorasib-Gerüst aus und lieferte ein validiertes Analogon.
Ergebnis des Designs:
- QED 0,77
- Synthetische Zugänglichkeit (SA) 2,44
- MW 359
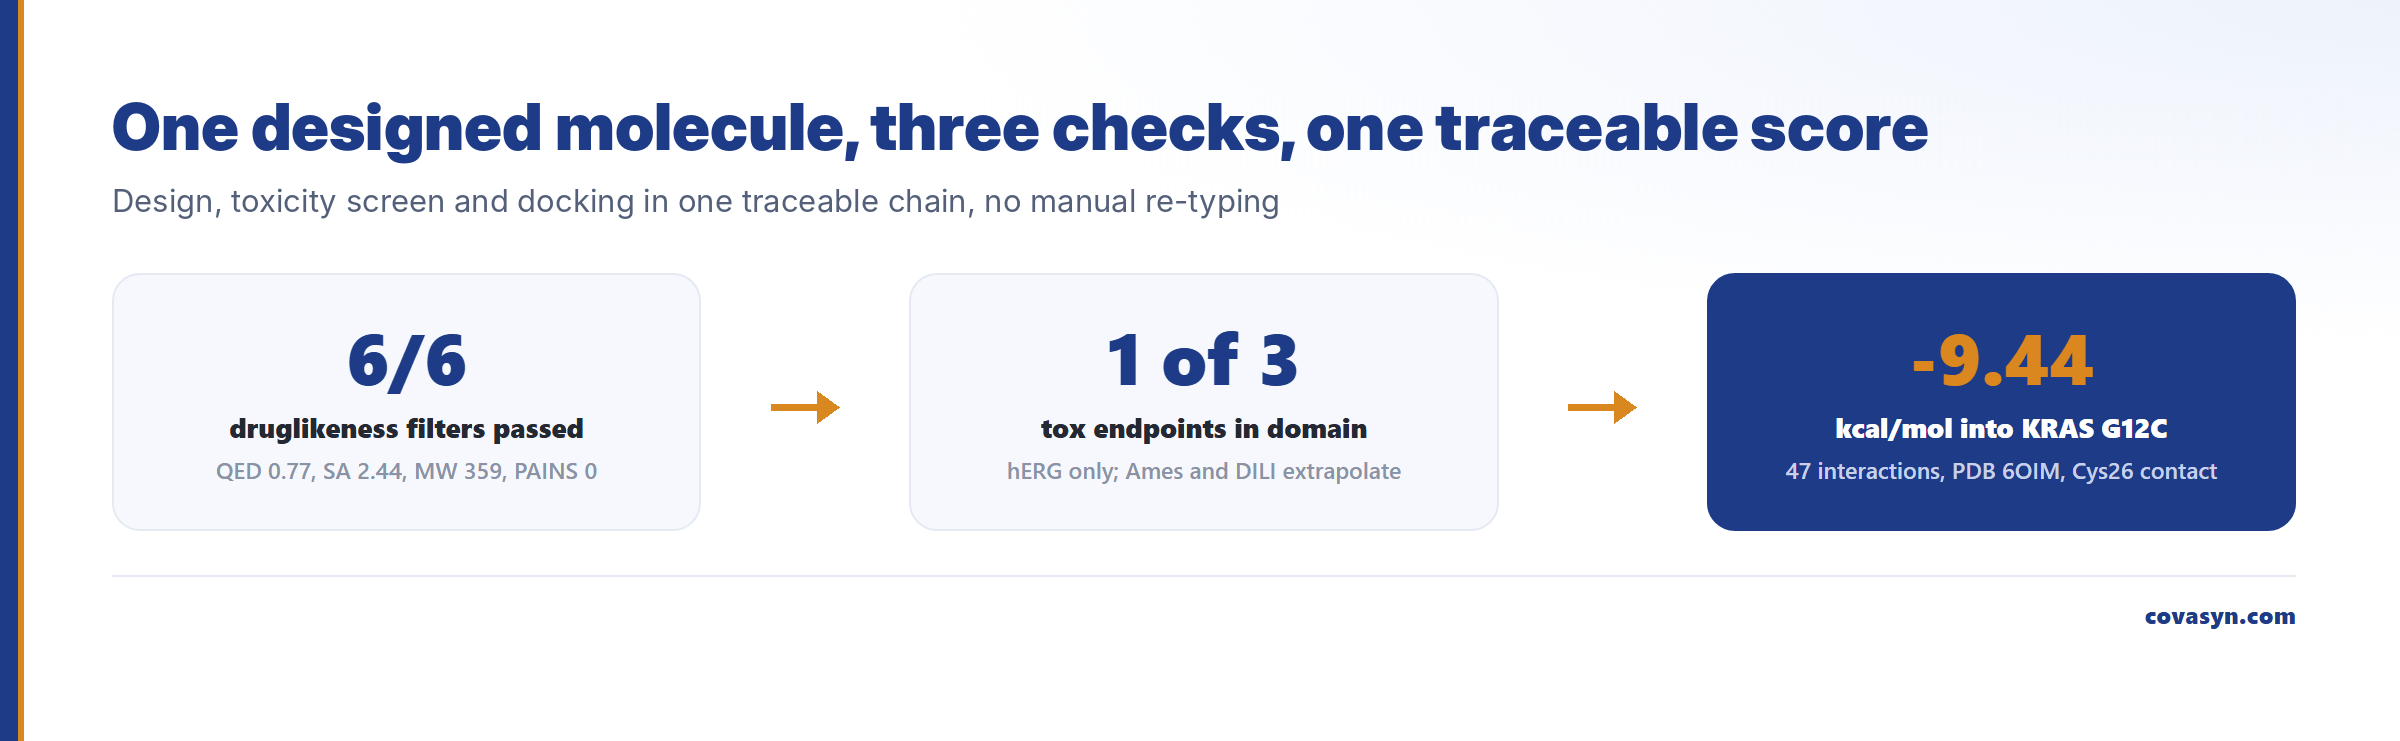
- 6 von 6 Drug-Likeness-Filtern bestanden
- Struktur validiert, PAINS 0, Brenk 0
Das ist ein sauberes Ergebnis für die Stufen 1 bis 3. Bei den meisten Vorführungen generativen Designs endet hier die Folie und das Wort „Kandidat“ erscheint. Sollte es aber nicht.
Was das Tox- und ADMET-Screening für dieselben SMILES ohne Änderungen lieferte:
| Endpunkt | Vorhersage | Domain-Status | Wie zu lesen |
|---|---|---|---|
| hERG | 0,0125, geringes Risiko | in domain | Handlungsrelevant. Kardiales Risiko als kurzfristiges Anliegen zurückstufen. |
| Ames | 0,84 | out of domain | Als Zahl nicht handlungsrelevant. Als Hinweis zum Testen behandeln, nicht als Ergebnis. |
| DILI | 0,90 | out of domain | Dasselbe. Ein hoher Score außerhalb der Domain ist ein Flag am Modell, nicht am Molekül. |
| Strukturelle Alerts | 3 | regelbasiert | Halogeniertes Aromat, CYP-Pyridin-/Pyrimidin-Motive. Bekannte Risiken, keine Vetos. |
Zwei der drei Modell-Endpunkte lieferten Zahlen, die alarmierend aussehen und für dieses Molekül nicht interpretierbar sind. Eine Auswertung, die „Ames-Risiko 0,84, HOCH“ ohne Domain-Kennzeichnung gemeldet hätte, hätte einen Chemiker einer Mutagenitätsgeschichte hinterherjagen lassen, für die das Modell keine Grundlage hat.
Dann die Bindungsfrage.
Unser Docking platzierte dieselbe designte SMILES-Struktur in KRAS G12C (PDB 6OIM) und lieferte −9,44 kcal/mol, eingestuft als „stark“, mit 47 protokollierten Interaktionen einschließlich eines Kontakts bei Cys26. Das ist ein realer Lauf, und es ist ein nicht kovalenter Rangwert gegen eine hinterlegte Struktur, keine Vorhersage kovalenter Bindung und keine Affinitätsmessung.
Was „in domain“ tatsächlich bringt
Die Applicability Domain ist eine Aussage über den Trainingsdatensatz, nicht über das Molekül. Ein Modell ist in domain, wenn die Anfrageverbindung innerhalb des chemischen Raums liegt, auf dem es gefittet wurde. Außerhalb dieses Raums liefert das Modell trotzdem eine Zahl, weil das Modelle nun einmal tun, aber die Zahl ist Extrapolation.
Im obigen Beispiel: hERG in domain bedeutet, unser hERG-Modell hat ähnliche Chemie schon gesehen, daher ist 0,0125 eine Zahl, auf die man handeln kann. Ames und DILI out of domain bedeutet, das Gerüst ist diesen Modellen unbekannt, daher tragen 0,84 und 0,90 keine kalibrierbare Information.
Für generatives Design zählt das mehr als für Bibliotheks-Screening, weil generative Modelle gerade darin gut sind, bekannten chemischen Raum zu verlassen. Je besser der Generator, desto häufiger liegen die ADMET-Modelle out of domain. Design und Filterung ziehen in entgegengesetzte Richtungen, und nur eine explizite Domain-Prüfung macht diese Spannung sichtbar.
Wie gut sind die Filter selbst
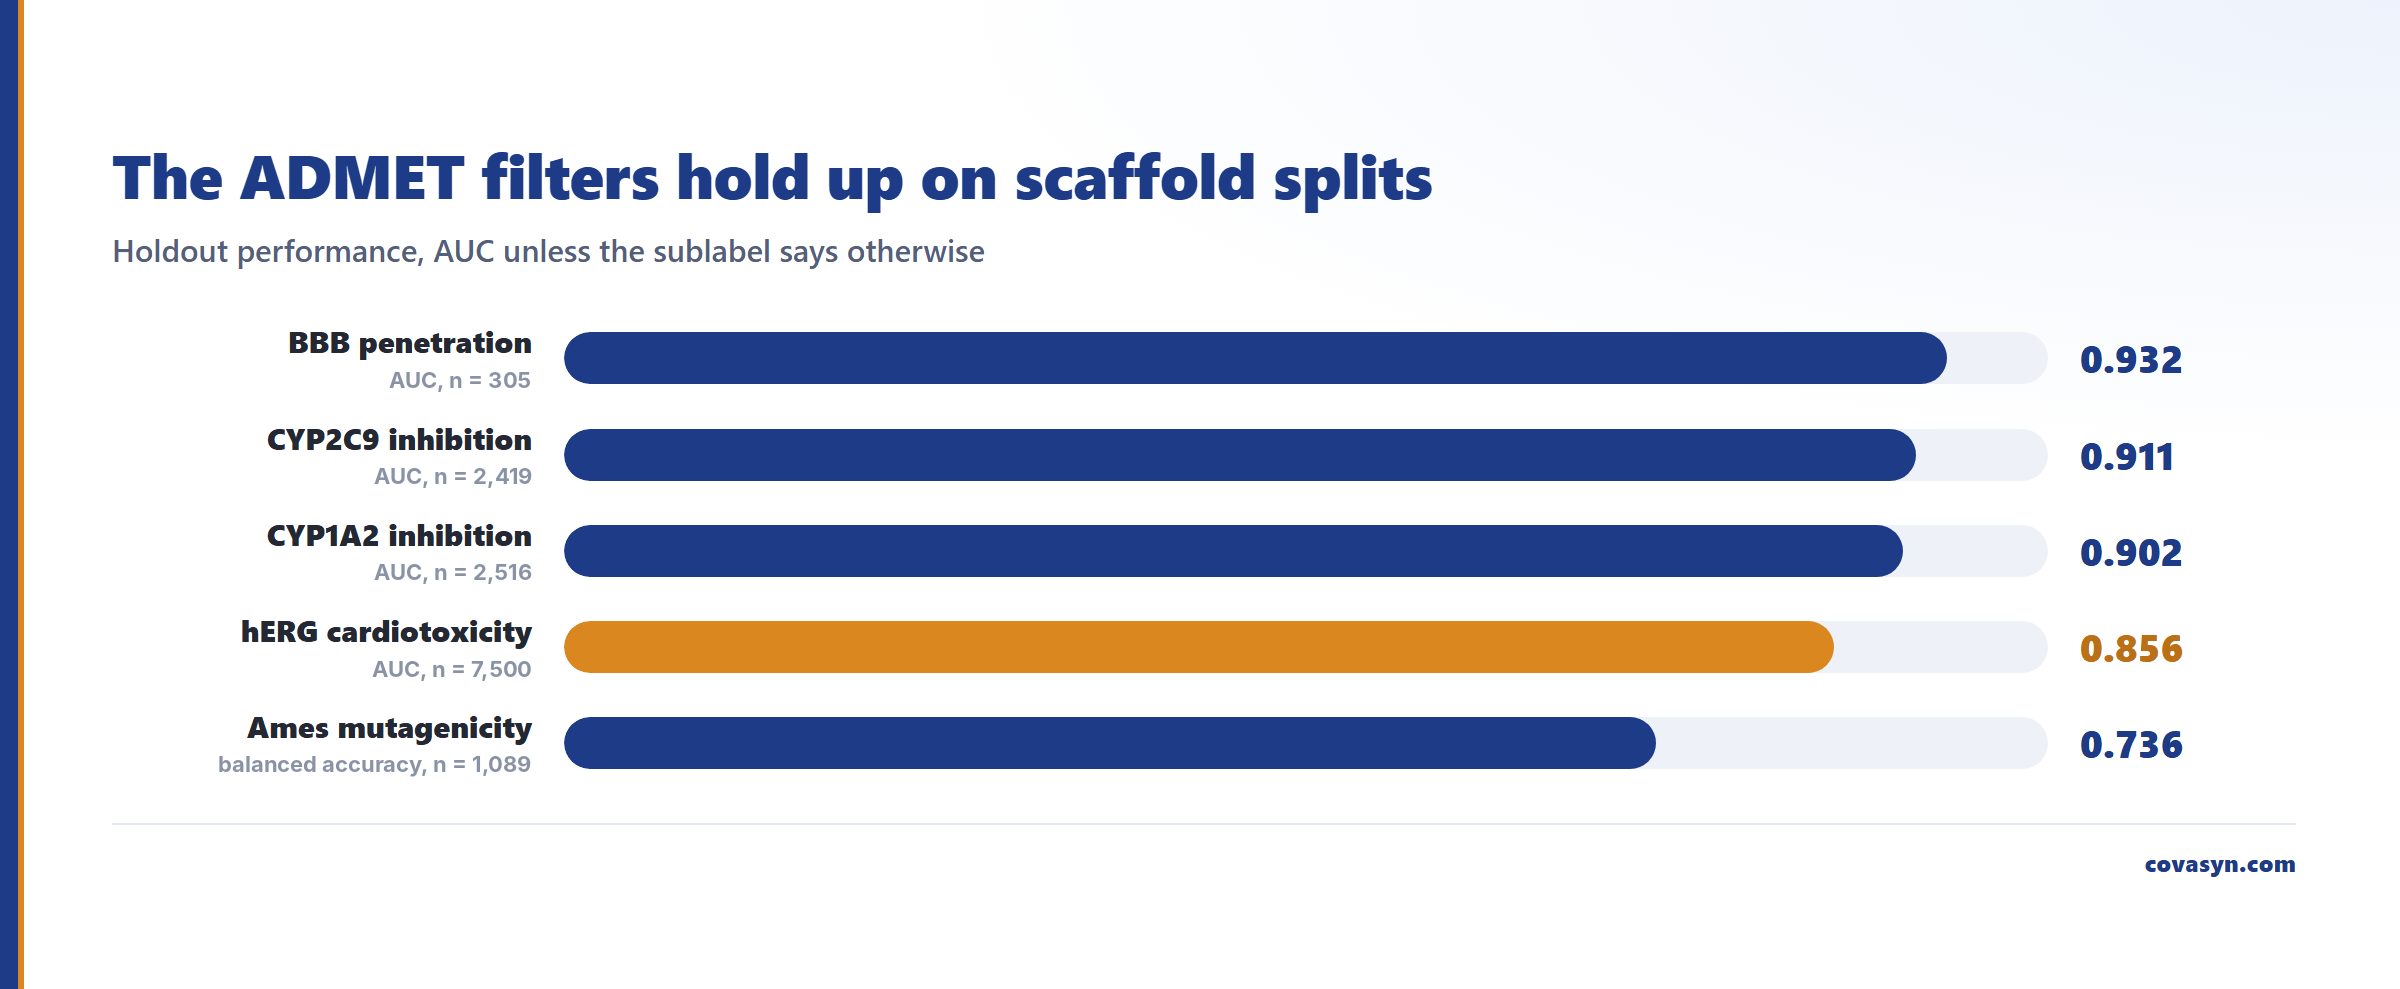
Domain-Flags helfen nur, wenn die In-domain-Vorhersagen etwas taugen. Unsere Modelle sind auf dem Scaffold-Split validiert, also mit Testverbindungen, deren molekulare Kerne im Training fehlen. Das ist der härtere und ehrlichere Split.
| Endpunkt | Metrik (Scaffold-Split) | n (Testsatz) |
|---|---|---|
| hERG (Kardiotoxizität) | AUC 0,856 | 7500 |
| CYP2C9-Hemmung | AUC 0,911 | 2419 |
| CYP1A2-Hemmung | AUC 0,902 | 2516 |
| Ames-Mutagenität | Balanced Accuracy 0,736 | 1089 |
| BBB-Penetration | AUC 0,932 | 305 |
Separat erreichte unser Ames-Modell auf dem offiziellen Split der TDC-ADMET-Benchmark-Gruppe (Training nur auf dem offiziellen Trainings-Split, 5 Wiederholungen, bewertet mit dem Evaluator von TDC) AUROC 0,847 ± 0,013 bei n = 1457 im Testsatz. Referenz: Huang et al., Nat Chem Biol 18, 1033 (2022) sowie das laufende Leaderboard auf tdcommons.ai.
Zwei Vorbehalte sind es wert, klar benannt zu werden. Erstens: Die Modelle der ersten Tabelle und das für den TDC-Split neu trainierte Modell sind unterschiedliche Fits, die beiden Tabellen sind also nicht unmittelbar vergleichbar. Zweitens: Mehrere publizierte ADMET-Endpunkte haben sehr kleine offizielle Testsets, DILI mit n = 96 und HIA mit n = 117 im TDC-Split, und eine als Kennzahl herausgestellte AUC auf weniger als 150 Verbindungen sollte keine Portfolioentscheidung tragen.
Was das nicht verrät
- Docking-Scores sind keine Affinitäten. −9,44 kcal/mol ordnet Posen innerhalb einer Kampagne gegen eine Struktur. Es sagt keine Ki voraus und sagt nichts über kovalente Bindungsbildung, auch wenn die Pose ein Cystein kontaktiert.
- Eine hERG-Vorhersage mit geringem Risiko ist kein unauffälliger Patch-Clamp-Befund. Es ist ein Prior, der die Reihenfolge der Assays festlegen hilft, nicht mehr.
- Scores außerhalb der Applicability Domain bedeuten nicht „wahrscheinlich unbedenklich“. Sie sind in beide Richtungen unbekannt. Ein DILI-Wert von 0,90 out of domain ist auch kein Sicherheitsbeweis.
- SA 2,44 ist eine Heuristik, keine Route. Ob das Molekül tatsächlich herstellbar ist, entscheiden Retrosynthese und chemisches Urteilsvermögen.
- 6 von 6 bestandenen Drug-Likeness-Filtern sind eine Mindestanforderung, kein positives Signal. Auch Moleküle, die aus anderen Gründen scheitern, bestehen Regeln nach Lipinski meist.
- Nichts davon ist eine regulatorische Position. Das sind Triage-Ausgaben zur Priorisierung von Experimenten.
Praktisches Vorgehen für eine Design-Kampagne
1. Breit generieren, dann die Stufen 1 bis 3 als harte Grenze anwenden. Sie kosten fast nichts und entfernen offensichtlichen Ausschuss. 2. Das Tox-Schnellscreening auf den Überlebenden ausführen und das Domain-Flag als vollwertige Spalte neben dem Score behalten. 3. In drei Gruppen aufteilen: in-domain-sauber, in-domain-geflaggt, out-of-domain. Nur die erste ist die engere Auswahl. Die dritte ist die Liste für Assays. 4. Docking nur für die engere Auswahl einsetzen.
Die knappe Ressource ist nicht die Rechenleistung. Es ist die Zahl der Moleküle, die ein Chemiker tatsächlich herstellen wird.
Häufige Fragen
Erzeugt generatives Moleküldesign synthetisierbare Moleküle?
Nicht automatisch. Generative Modelle optimieren die vorgegebene Zielfunktion, und Validität ist keine Herstellbarkeit. Ein Score für synthetische Zugänglichkeit ist die günstige erste Prüfung: Das oben gezeigte Analogon erreichte SA 2,44, was im herstellbaren Bereich liegt. Das ist eine Heuristik auf Basis von Fragmenthäufigkeit, keine Route. Alles, was tatsächlich hergestellt werden soll, sollte vor Laborzeit mit Retrosyntheseplanung und chemischer Prüfung bestätigt werden.
Welche ADMET-Endpunkte sollten einen generativen Design-Lauf filtern?
Mindestens hERG, Ames-Mutagenität, CYP-Hemmung und ein Permeabilitäts- oder BBB-Endpunkt, je nach Zielkompartiment. Auf unseren Scaffold-Split-Holdouts sind das die besser abgesicherten Endpunkte: hERG AUC 0,856 (n = 7500), CYP2C9 AUC 0,911 (n = 2419), Ames Balanced Accuracy 0,736 (n = 1089). Endpunkte mit Testsets unter etwa 150 Verbindungen können die Triage stützen, sollten aber kein Programm blockieren.
Was bedeutet „außerhalb der Applicability Domain“ für einen vorhergesagten Toxizitätsscore?
Es bedeutet, dass das Anfragemolekül außerhalb des chemischen Raums liegt, auf dem das Modell trainiert wurde, sodass die Zahl Extrapolation statt Vorhersage ist. Im durchgerechneten Beispiel lieferte das ADMET-Screening Ames 0,84 und DILI 0,90, flaggte aber beide als out of domain, während hERG mit 0,0125 in domain lag. Die korrekte Reaktion auf eine solche Kennzeichnung ist, einen Assay einzuplanen, und nicht, dem Score zu vertrauen oder ihn stillschweigend zu verwerfen.
Warum lösen generative Modelle so oft Out-of-domain-Flags aus?
Weil sie genau dafür da sind. Ein Generator, der nur Moleküle erzeugt, die dem Trainingsdatensatz der ADMET-Modelle ähneln, bringt wenig zusätzlichen Wert. Je neuartiger die Chemie, desto weiter liegt sie von den QSAR-Trainingsverteilungen entfernt, und desto häufiger schlägt die Domain-Prüfung an. Das ist eine strukturelle Spannung im De-novo-Design, kein Fehler der Modelle; deshalb muss die Domain-Kennzeichnung den Score immer begleiten.
Kann ein Docking-Score ein generativ designtes Molekül bestätigen?
Er kann eine Bindungshypothese stützen und Kandidaten gegeneinander ordnen. Unser Docking lieferte für das designte Analogon gegen KRAS G12C (PDB 6OIM) −9,44 kcal/mol mit 47 Interaktionen und einem Cys26-Kontakt. Das ist ein nicht kovalenter Rangwert gegen eine hinterlegte Struktur. Es ist keine Affinität, keine Vorhersage kovalenter Bindung, und es ersetzt keinen biochemischen Assay.
Wie viele generierte Moleküle überstehen typischerweise einen vollständigen Filterstapel?
Es gibt keine allgemeingültige Zahl; sie hängt vollständig vom Generator, dem Seed-Gerüst und der Strenge der Domain-Grenze ab. Die nützliche Kennzahl ist nicht die Überlebensrate, sondern die Zusammensetzung der Überlebenden: wie viele sind in-domain-sauber gegenüber out-of-domain. Wenn fast alles out of domain liegt, erkunden ADMET-Modelle und Generator unterschiedliche chemische Räume, und es braucht experimentelle Daten, bevor der Filterstapel überhaupt etwas bedeutet.
Weiterführende Artikel
Gerechnet mit CovaSyn
Die Zahlen in diesem Artikel stammen aus unseren Werkzeugen.
- ADME-Profile, Druglikeness, Molekül-Design.
- ICH M7, Tox21, CYP450, Strukturalerts, ADMET-Triage.