

Jedes QSAR-Modell liefert für jedes eingespeiste Molekül eine Zahl. Das ist das Problem. Ein an 1.000 zugelassenen Wirkstoffen trainiertes Modell gibt trotzdem eine überzeugend wirkende Wahrscheinlichkeit für einen Peptid-Makrozyklus, einen borhaltigen Warhead oder ein perfluoriertes Tensid aus, dem es nie zuvor auch nur ähnlich begegnet ist. Die Applicability Domain ist der Mechanismus, der zeigt, welche dieser Zahlen tatsächlich handlungsrelevant sind.
Was der Anwendungsbereich (Applicability Domain) eines QSAR-Modells ist
Die Applicability Domain (AD), auf Deutsch Anwendungsbereich, ist der Bereich des chemischen Raums, in dem die Fehlerabschätzung eines Modells noch durch Evidenz gestützt ist. Sie ist OECD-Validierungsprinzip 3 für QSAR-Modelle, neben einem definierten Endpunkt, einem eindeutigen Algorithmus, Goodness-of-Fit-Maßen und einer mechanistischen Interpretation. Ohne AD-Aussage ist ein QSAR-Ergebnis keine validierte Vorhersage. Es ist eine Extrapolation mit Nachkommastelle.
Praktisch beantwortet die AD eine Frage: Wie viel vom Trainingssatz liegt in der Nähe dieses Moleküls? Lautet die Antwort „nichts in Reichweite“, interpoliert das Modell zwischen Punkten, die nicht existieren, und die aus einer Benchmark-Tabelle abgelesene Holdout-Genauigkeit überträgt sich nicht.
Applicability Domain in QSAR bestimmen: die drei gängigen Methoden
Die meisten produktiven Systeme kombinieren zwei oder drei davon. Sie versagen auf unterschiedliche Weise, weshalb sich die Kombination lohnt.
| Methode | Was sie misst | Versagt bei |
|---|---|---|
| Nächste-Nachbarn-Ähnlichkeit (Tanimoto auf Fingerprints) | Strukturelle Distanz zur nächsten Trainingsverbindung | Ähnliche Struktur, anderer Wirkmechanismus (Activity Cliffs) |
| Feature Range / Bounding Box | Ob jeder Deskriptor innerhalb des Trainings-Min-Max liegt | Jeder Deskriptor liegt einzeln im Bereich, aber die Kombination ist neu |
| Leverage (Williams-Plot, Hat-Matrix) | Distanz vom Deskriptorraum-Zentroid, relativ zu einem h*-Cutoff | Setzt ein lineares Modell voraus; irreführend bei Baum-Ensembles |
Unsere Auswertung prüft für jede Vorhersage, ob die Verbindung chemisch zu dem passt, worauf die Vorhersage beruht, und weist das Ergebnis getrennt aus. Eine Verbindung gilt nur dann als innerhalb des Anwendungsbereichs, wenn beide Prüfungen in der Tabelle unten bestehen.
Rechenbeispiel: dasselbe Molekül, drei Urteile
Nehmen wir einen repräsentativen EGFR-Inhibitor aus der Klasse zugelassener Wirkstoffe (Gefitinib, SMILES COc1cc2ncnc(Nc3ccc(F)c(Cl)c3)c2cc1OCCCN1CCOCC1). Das ist keine neuartige Verbindung, sondern eine gut charakterisierte Referenz. Unten stehen die Ergebnisse unserer Anwendungsbereichsprüfung vom 25.07.2026.
| Endpunkt | im Anwendungsbereich | Ähnlichkeit zum nächsten Nachbarn | Deskriptor-Abdeckung |
|---|---|---|---|
| Tox21 NR-AR | ja | 1,00 | 0,9635 |
| hERG | ja | 0,75 | 0,9650 |
| DILI | nein | 0,00 | 0,9808 |
Dasselbe Molekül, drei unterschiedliche Antworten. Das Tox21-NR-AR-Ergebnis liegt bei 1,00, weil Gefitinib buchstäblich in der Tox21-Screening-Bibliothek enthalten ist, der nächste Nachbar also es selbst ist. hERG liegt bei 0,75, komfortabel innerhalb eines großen, chemisch diversen Trainingssatzes. DILI liefert 0,00 Ähnlichkeit, sodass die Tanimoto-Prüfung versagt, obwohl 98 Prozent seiner Deskriptoren im Bereich liegen. Das ist der Bounding-Box-Fehlerfall aus der Tabelle oben, erfasst von der zweiten Methode.
Was mit diesem Urteil geschehen muss
Eine Vorhersage außerhalb des Anwendungsbereichs darf nicht dieselbe Geltung behalten wie eine Vorhersage innerhalb. Die Regel, die wir dafür anwenden, ist bewusst kompromisslos: Fällt die Anwendungsbereichsprüfung durch, gilt die Vorhersage als nicht entscheidungsreif, unabhängig von der berichteten Gesamtgenauigkeit des Endpunkts. Ein Modell behält seine Verlässlichkeit nicht an einem Molekül, das es nie gesehen hat.
An derselben Verbindung sieht das so aus. Für hERG, innerhalb des Anwendungsbereichs, ergibt sich eine Wahrscheinlichkeit von 0,15, eine mittlere Risikostufe und ein eindeutiges Prediction Set bei 90 Prozent Abdeckung. Für DILI, außerhalb des Anwendungsbereichs, ergibt sich eine Wahrscheinlichkeit von 0,90, ebenfalls mit eindeutigem Prediction Set.
Bemerkenswert ist, was *nicht* passiert. Die DILI-Wahrscheinlichkeit bleibt 0,90. Sie wird nicht versteckt oder weggerundet. Was sich ändert, ist die Konfidenz, die deutlich abfällt, und die Risikoeinordnung, die von „hoch“ zu „unsicher“ wird. Eine DILI-Markierung von 0,90 außerhalb des Anwendungsbereichs ist ein Grund, die Verbindung mit einem Toxikologen anzusehen. Es ist kein Grund, die Serie zu beenden.
Conformal Prediction: die andere Hälfte der Antwort
Ähnlichkeit zeigt, ob das Modell diese Nachbarschaft gesehen hat. Conformal Prediction zeigt, wie breit die Antwort sein muss, um eine Abdeckungsgarantie zu halten. Unsere Auswertung liefert ein Prediction Set bei einem angegebenen Abdeckungsniveau (oben 0,90). Das relevante Signal ist die Größe dieses Sets:
- eine Klasse im Set: eine Klasse übersteht 90 Prozent Abdeckung. Das Modell entscheidet sich.
- beide Klassen im Set: beide überstehen. Das Modell kann sie bei diesem Abdeckungsniveau nicht trennen. Das ist das ehrliche „ich weiß es nicht“, ein anderer Fehlerfall als out of domain.
Ein Molekül kann in-domain mit einem Zwei-Klassen-Set sein (das Modell hat diese Chemie gesehen, und sie ist tatsächlich ambivalent) oder out-of-domain mit einem Ein-Klassen-Set (eine überzeugend wirkende Antwort ohne evidenzielle Stütze). Beide Angaben lesen. Sie sind nicht redundant.
Warum die berichtete Genauigkeit das nicht klärt
Auf einem zurückgehaltenen, nach Gerüst getrennten Testsatz erreicht hERG einen AUC-Wert von 0,856 bei n = 7.500 Testverbindungen und DILI einen AUC-Wert von 0,909 bei n = 72. Die DILI-Zahl ist höher. Sie ist zugleich die deutlich schwächere Aussage: 72 Testverbindungen, und ein Trainingssatz eng genug, dass ein zugelassener EGFR-Inhibitor außerhalb davon fällt. Jeder ohne Testsatzgröße und Split-Typ zitierte AUC-Wert ist Dekoration.
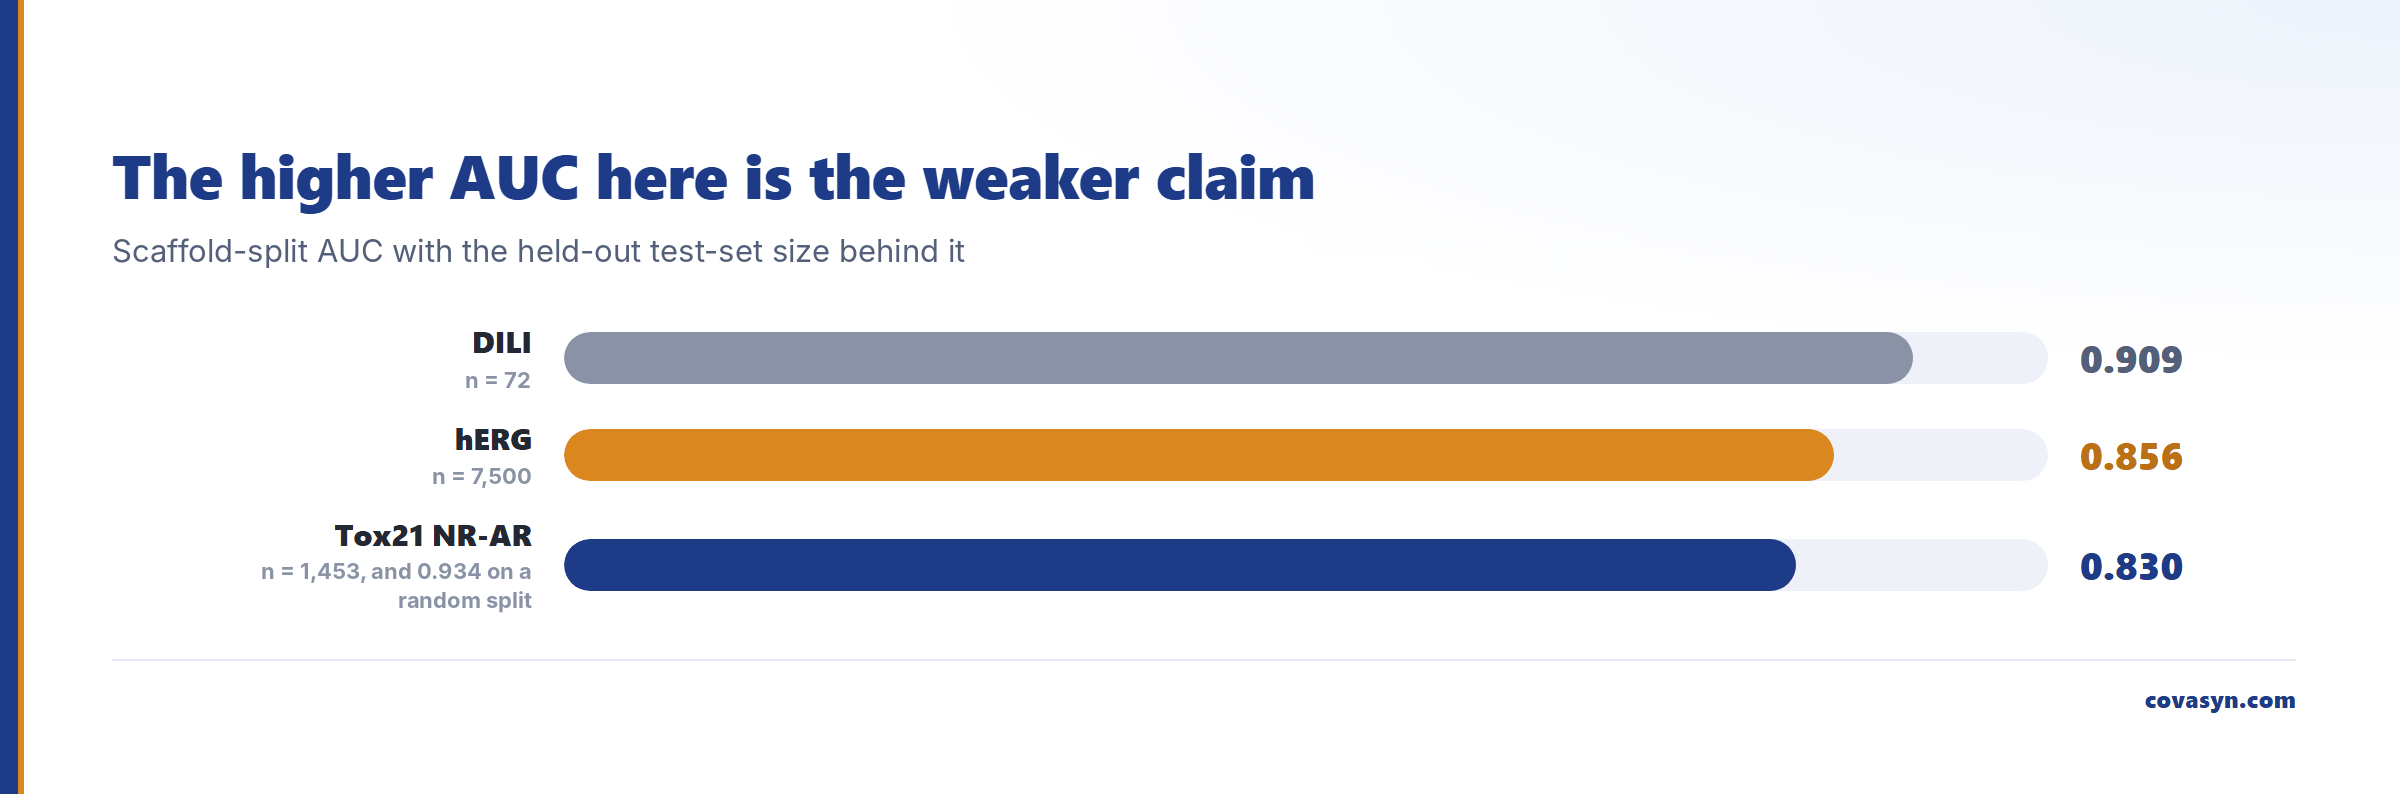
Wir berichten Scaffold-Split-Zahlen als Hauptkennzahl, weil bei zufälligen Splits Information ins Training durchsickert. Die Lücke ist in unseren eigenen Daten sichtbar: Tox21 NR-AR liegt bei 0,830 nach Gerüst getrennt gegenüber 0,934 bei zufälliger Trennung, jeweils bei n = 1.453 Testverbindungen. Gleiches Modell, gleicher Endpunkt. Die 0,934 ergibt sich, wenn Analoga der Testverbindungen im Trainingssatz sitzen. Die AD-Prüfung zeigt, in welchem der beiden Regime sich die konkrete Anfrage befindet.
Ehrliche Grenzen
Was die Applicability Domain nicht sagt:
- Sie validiert die Vorhersage nicht. In-domain bedeutet, das Modell hat hier Evidenz. Es bedeutet nicht, dass das Modell recht hat. hERG bei 0,856 Scaffold-AUC klassifiziert auch innerhalb seiner Domain noch Verbindungen falsch.
- Ähnlichkeit ist kein Mechanismus. Zwei Verbindungen bei Tanimoto 0,9 können auf entgegengesetzten Seiten eines Activity Cliffs sitzen. Fingerprint-Ähnlichkeit ist ein Proxy für mechanistische Relevanz, kein Ersatz.
- Schwellenwerte sind Konventionen. Ein Tanimoto-Cutoff im Bereich von 0,3 ist ein verbreiteter Arbeitsstandard, kein Naturgesetz. Für regulatorisch relevante Arbeit enger fassen.
- Die Abdeckung des Referenzsatzes zählt. Für manche Endpunkte liegt ein vollständiger Ähnlichkeits-Referenzsatz vor, für andere nicht, und wo er fehlt, entscheidet die Prüfung im Zweifel auf außerhalb des Anwendungsbereichs. Das ist Absicht. Ein fehlender Referenzsatz darf niemals als „in domain“ gelesen werden.
- Nichts davon ist eine regulatorische Einreichung. Diese Auswertung ist Triage und Entscheidungsunterstützung. Eine ICH-M7- oder ICH-S-Serie-Einreichung braucht validierte Assays und fachliche Prüfung.
Häufige Fragen
Was ist die Applicability Domain (der Anwendungsbereich) in QSAR?
Die Applicability Domain ist der Bereich des chemischen Raums, in dem die Vorhersagen eines QSAR-Modells durch seine Trainingsdaten gestützt sind. Sie ist OECD-Validierungsprinzip 3 für QSAR-Modelle. Außerhalb dieses Bereichs extrapoliert das Modell, und seine berichtete Genauigkeit gilt nicht mehr. Eine Vorhersage ohne Applicability-Domain-Aussage ist kein validiertes Ergebnis, und die meisten regulatorischen Prüfer werden sie so behandeln.
Wie wird die Applicability Domain berechnet?
Drei Methoden dominieren. Nächste-Nachbarn-Ähnlichkeit misst die Tanimoto-Distanz von der Anfrage zur nächsten Trainingsverbindung. Feature Range prüft, ob jeder Deskriptor innerhalb von Trainingsminimum und -maximum liegt. Leverage misst die Distanz vom Deskriptorraum-Zentroid gegen einen h*-Cutoff. Unsere Auswertung kombiniert Nächste-Nachbarn-Ähnlichkeit mit der Deskriptor-Abdeckung und verlangt, dass beide Prüfungen bestehen, bevor eine Verbindung als innerhalb des Anwendungsbereichs gilt.
Was passiert, wenn eine Vorhersage out of domain ist?
Bei uns gilt die Vorhersage dann als nicht entscheidungsreif: die Konfidenz wird deutlich herabgesetzt und die Risikostufe auf „unsicher“ gesetzt. Die Wahrscheinlichkeit wird weiterhin ausgegeben. Für den EGFR-Inhibitor Gefitinib blieb die DILI-Vorhersage bei 0,90, galt aber als unsicher, weil die Ähnlichkeit zum nächsten Nachbarn im DILI-Trainingssatz 0,00 betrug.
Wie unterscheidet sich Conformal Prediction von einer Applicability-Domain-Prüfung?
Sie beantworten unterschiedliche Fragen. Die Applicability Domain fragt, ob das Modell diese Chemie gesehen hat. Conformal Prediction fragt, wie breit die Antwort sein muss, um eine angegebene Abdeckungsgarantie zu halten, typischerweise 90 Prozent. Ein Prediction Set mit beiden Klassen bedeutet, das Modell kann sie nicht trennen, selbst in vertrauter Chemie. Beide Angaben lesen: Eine Verbindung kann in-domain und ambivalent sein, oder out-of-domain und fälschlich entschieden wirken.
Kann ein hoher AUC-Wert als Beweis genutzt werden, dass ein Modell bei meinen Verbindungen funktioniert?
Nein. AUC wird an einem spezifischen Testsatz mit einem spezifischen Split gemessen. In unserer Auswertung erreicht DILI 0,909 AUC bei nur 72 Testverbindungen und hERG 0,856 bei 7.500. Die größere, niedrigere Zahl ist die stärkere Aussage. Immer nach Testsatzgröße fragen und ob der Split scaffold-basiert oder zufällig war. Zufällige Splits blähen Scores auf, indem Analoga ins Training gelangen.
Was ist ein angemessener Tanimoto-Schwellenwert für die Applicability Domain?
0,3 auf Morgan-artigen Fingerprints ist ein gängiger Arbeitsstandard in der Literatur. Es ist eine Konvention, keine physikalische Konstante. Für regulatorisch relevante oder sicherheitskritische Entscheidungen höher setzen und zusätzlich eine engere Feature-Coverage-Grenze verlangen. Den verwendeten Schwellenwert bei jeder Vorhersage angeben, denn dasselbe Molekül wechselt den Domain-Status, wenn der Cutoff sich verschiebt.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- ICH M7, Tox21, CYP450, Strukturalerts, ADMET-Triage.