

Sie fitten eine quadratische Response Surface, R-Quadrat liegt bei 0,9988, und alles wirkt fertig. Dann markiert das Diagnostik-Panel einen Normalitätstest bei p = 0,036 und zeigt auf Lauf 9. Die Frage ist nicht, ob die Markierung real ist. Die Frage ist, ob sie bedeutet, dass Ihr Modell falsch ist, oder ob sie bedeutet, dass Ihr Design genau das tut, was ein Central Composite Design tun soll.
Wofür Residualdiagnostik eigentlich da ist
Ein Response-Surface-Modell liefert Ihnen Koeffizienten, p-Werte und ein R-Quadrat. Keines davon sagt Ihnen, ob die *Annahmen hinter* diesen Zahlen gehalten haben. Residualdiagnostik tut das. Sie ist das Modell, das sich selbst prüft.
Drei Prüfungen tragen fast das gesamte Gewicht:
- Shapiro-Wilk fragt, ob die Residuen normalverteilt aussehen. Auf Normalität bauen Ihre Konfidenzintervalle, Prädiktionsintervalle und Term-p-Werte auf.
- Cooks Distanz fragt, wie stark sich die gesamte gefittete Fläche verschieben würde, wenn man einen Lauf entfernte. Das ist Einfluss, kein Fehler.
- Leverage (die Diagonale der Hat-Matrix) fragt, wie weit ein Lauf im Faktorraum vom Zentrum des Designs entfernt liegt. Das ist eine Eigenschaft des *Designs*, nicht der gemessenen Daten.
Die letzten beiden zu verwechseln ist der häufigste Fehler, den wir sehen. Hohe Leverage ist kein Mangel. Sie ist der Grund, warum axiale Punkte existieren.
Ein Praxisbeispiel an einem echten Central Composite Design
Die folgenden Zahlen stammen aus demselben 18-Lauf-Central-Composite-Design (8 faktoriell, 6 axial, 4 im Zentrum), das auch in unserer RSM-Design-Space-Arbeit genutzt wurde: ein katalytischer Schritt mit drei Faktoren (Temperatur, Katalysatorbeladung, Zeit), quadratisch gefittet bei R-Quadrat 0,9988 (adjustiert 0,9974) und anschließend mit der Residualdiagnostik von CovaSyn geprüft.
Vorbehalt vorab, weil er dafür wichtig ist, wie Sie diese Zahlen lesen: Das CCD selbst ist ein echtes Design, und jede zitierte Statistik ist echt berechnet, aber die Ausbeuten pro Lauf wurden aus einer quadratischen Fläche mit hinzugefügtem Rauschen simuliert, um Laborwerte zu ersetzen. Nehmen Sie das *Verhalten* der Diagnostik als Lektion, nicht die konkreten Ausbeutewerte.
| Diagnostik | Ergebnis | Konventioneller Grenzwert | Lesart |
|---|---|---|---|
| Shapiro-Wilk W | 0,888, p = 0,036 | p < 0,05 verwirft Normalität | Normalität verworfen |
| Max. Cooks Distanz | 0,277 bei Lauf 9 | 4/n = 0,222 (sensitiv); 1,0 (einflussreich) | Markiert, nicht einflussreich |
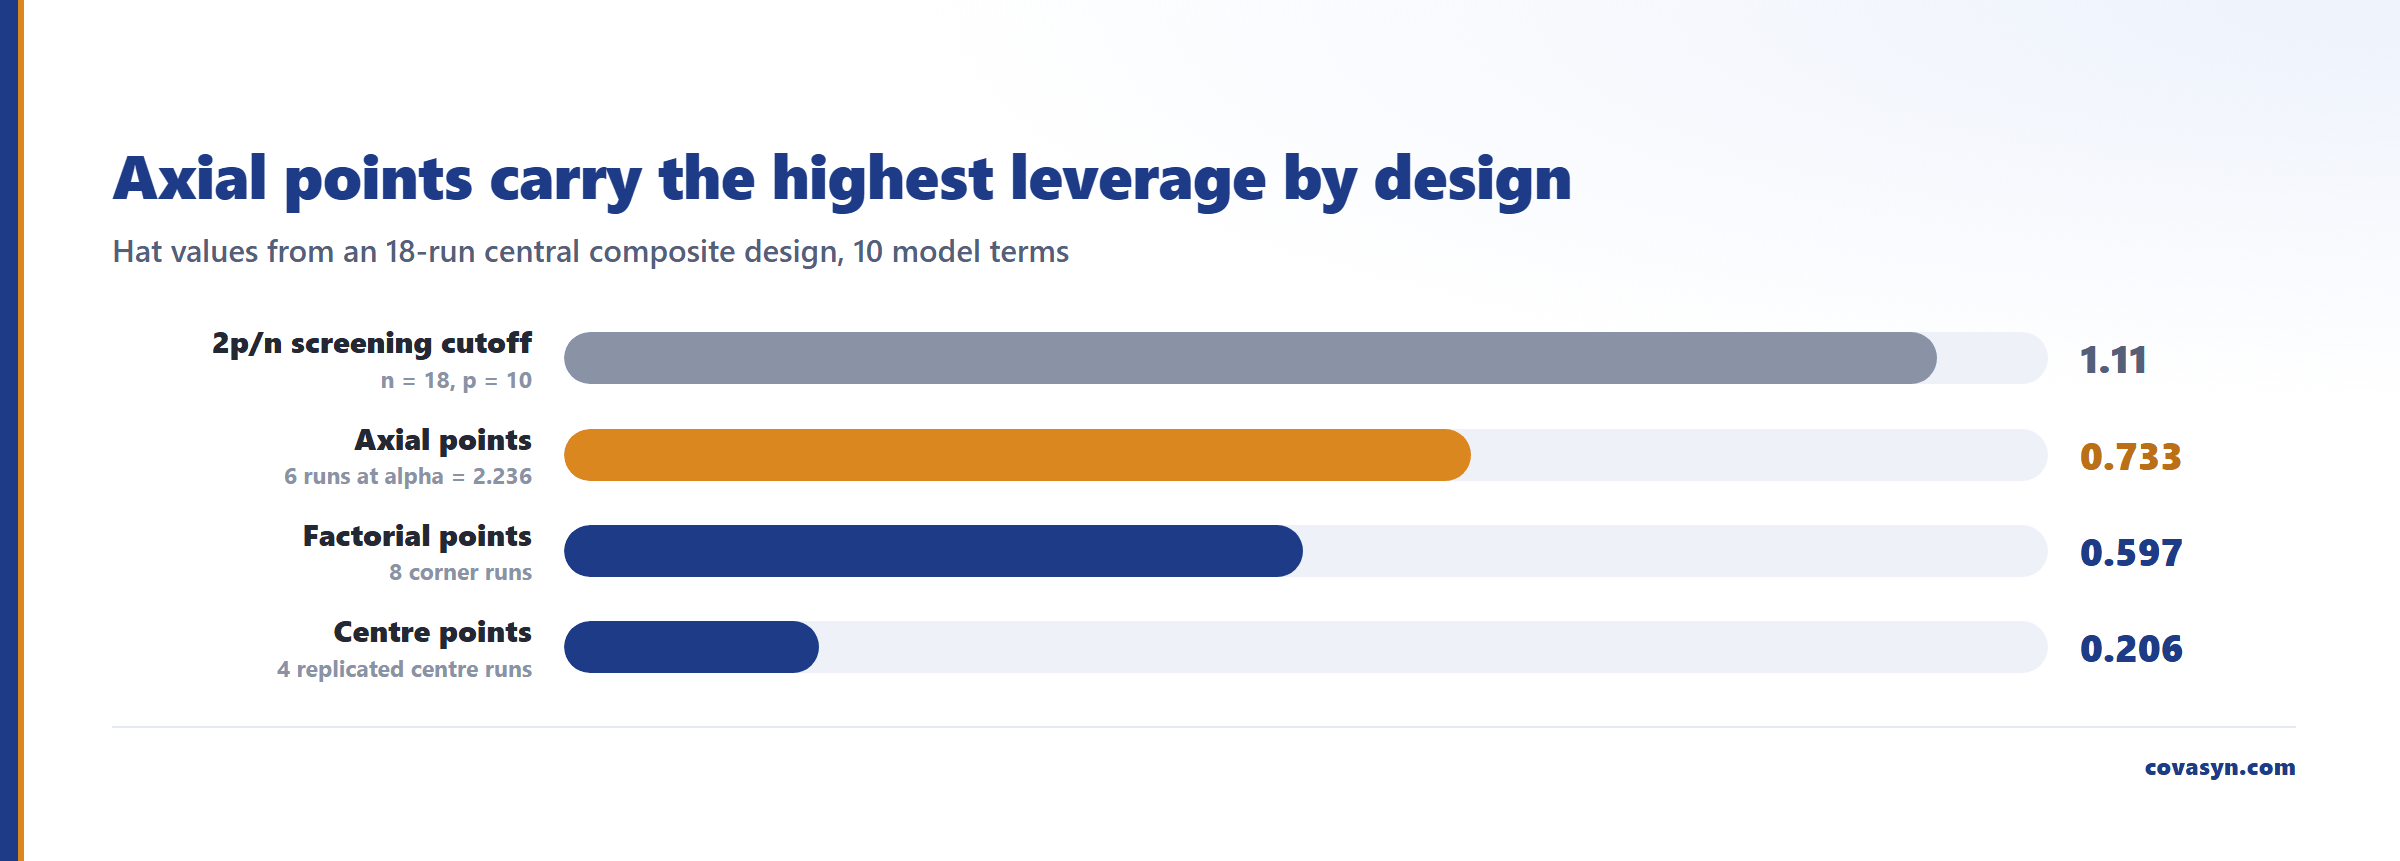
| Leverage, Zentrumspunkte | 0,206 | 2p/n = 1,11 | Niedrig, wie geplant |
| Leverage, faktorielle Punkte | 0,597 | 2p/n = 1,11 | Normal |
| Leverage, axiale Punkte | 0,733 | 2p/n = 1,11 | Am höchsten, wie geplant |
n = 18 Läufe, p = 10 Modellterme (Achsenabschnitt, 3 linear, 3 Zweifaktor-Interaktionen, 3 quadratisch).
Eine Plausibilitätsprüfung, die Sie selbst durchführen können
Leverages in einem Ordinary-Least-Squares-Fit müssen sich zur Anzahl der geschätzten Parameter aufsummieren. Hier: 4 × 0,206 + 8 × 0,597 + 6 × 0,733 = 9,998, was gerundet 10 ergibt. Das ist die Anzahl der Terme im quadratischen Modell. Liefert Ihre Software Leverages, die sich nicht zu p aufsummieren, ist vorher etwas schiefgelaufen: eine doppelte Zeile, ein fehlender Term, ein rangdefizientes Design. Diese Prüfung dauert zehn Sekunden und deckt echte Probleme auf.
Warum axiale Punkte die höchste Leverage zeigen, und warum das in Ordnung ist
In diesem Central Composite Design liegen die axialen (Stern-)Punkte bei alpha = 2,236 in codierten Einheiten und damit weiter vom Designzentrum entfernt als jede faktorielle Ecke (Abstand √3 ≈ 1,732). Rotierbar ist das Design damit nicht; das wäre es bei drei Faktoren mit alpha = 1,682. Leverage steigt mit dem Abstand vom Zentroid, also *müssen* die axialen Punkte hier die höchsten Hat-Werte haben. Das ist kein Fehler im Experiment. Diese Punkte sind die einzigen Läufe, die überhaupt eine reine quadratische Krümmung schätzen lassen. Entfernt man sie, kann das Modell keine Krümmung sehen, und genau deshalb wurde ein CCD statt eines rein faktoriellen Designs gefahren.
Markiert ein Diagnostik-Panel also einen axialen Lauf, ist die richtige erste Reaktion: erwartet. Das Design hat diesen Punkt absichtlich dort platziert, und der Fit stützt sich absichtlich darauf.
Bei 0,733 liegt die axiale Leverage weit unter dem üblichen Screening-Grenzwert 2p/n = 1,11. Beachten Sie aber: Leverage kann höchstens 1 betragen, bei so wenigen Läufen pro Modellterm greift die 2p/n-Regel also gar nicht. Da jeder Lauf an seiner geplanten Position liegt, ist nichts in diesem Design ein Ausreißer im Faktorraum.
Wie Sie eine Cooks Distanz von 0,277 lesen
Cooks D kombiniert Leverage mit der Größe des Residuums. Lauf 9 lieferte 0,277, den größten Wert im Datensatz.
Zwei Grenzwerte sind gebräuchlich, und sie widersprechen sich absichtlich:
- 4/n, hier 4/18 = 0,222. Ein bewusst sensitives Screening. 0,277 übersteigt ihn, weshalb der Lauf markiert wird.
- D > 1. Der klassische Schwellenwert für „dieser Lauf ist wirklich einflussreich“. 0,277 liegt weit davon entfernt.
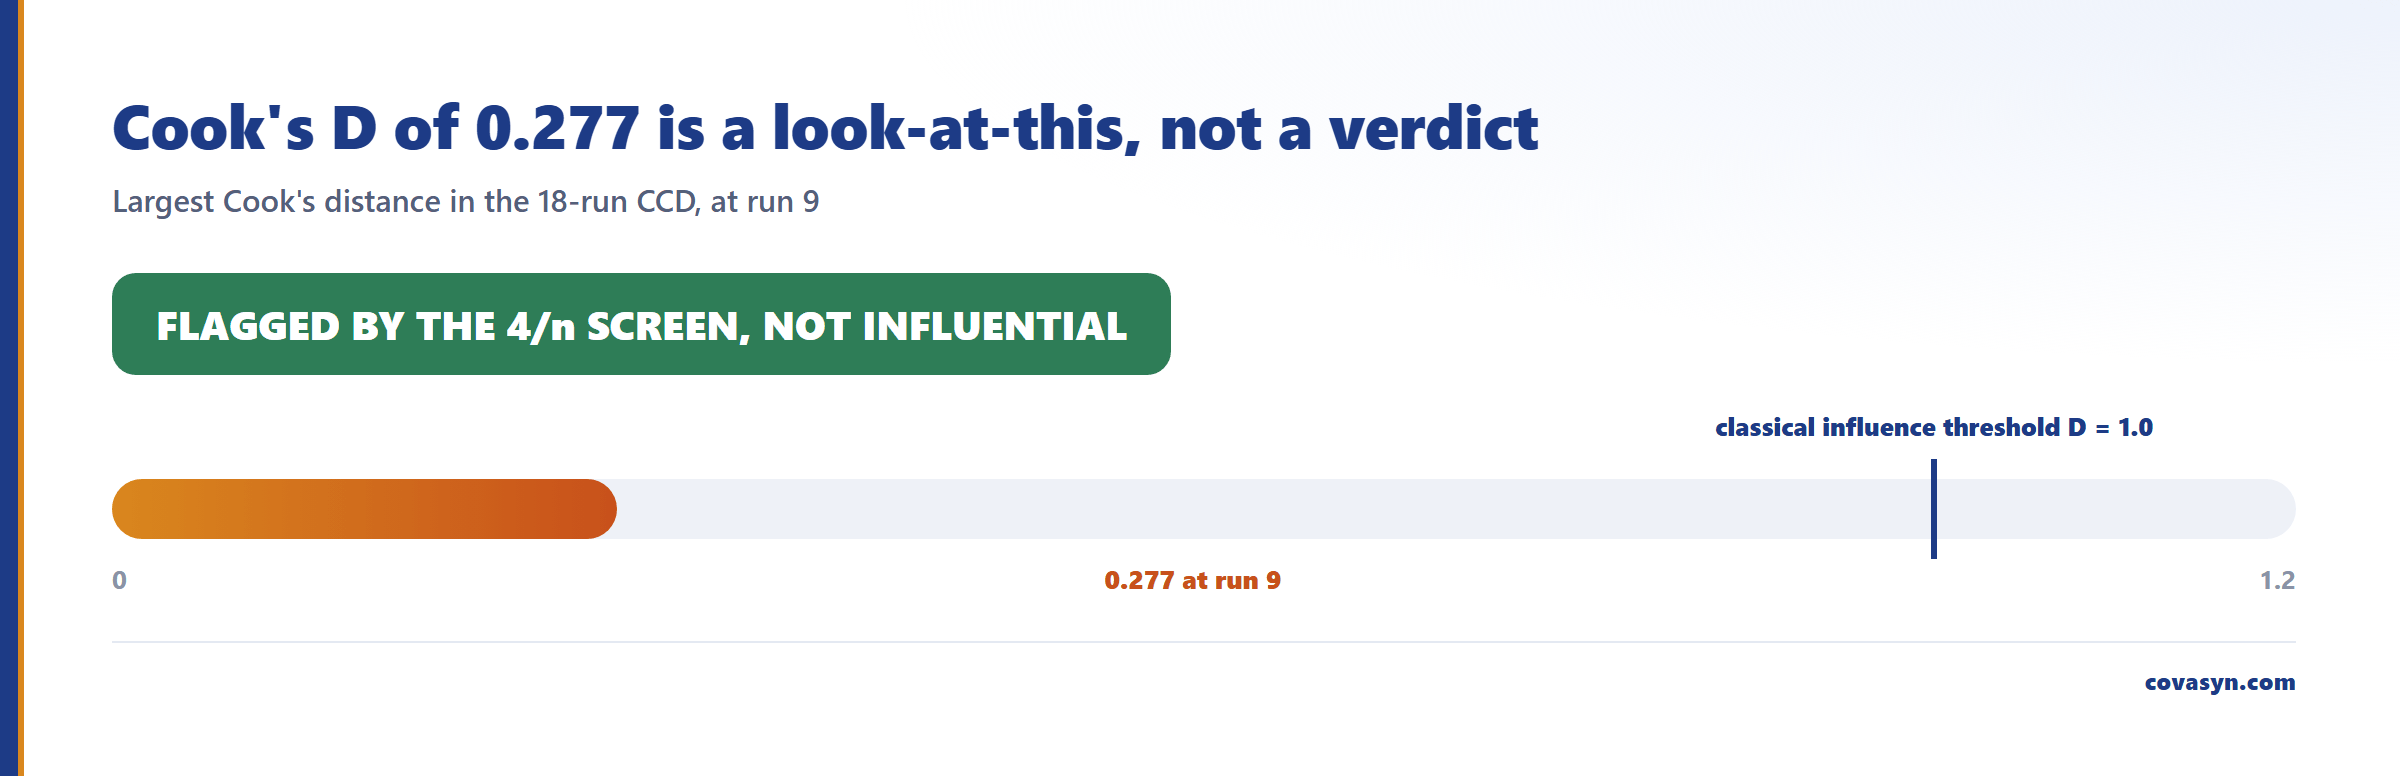
Die ehrliche Lesart: Lauf 9 zieht die Fläche stärker als seine Nachbarn, aber ihn zu löschen würde das gefittete Modell nicht nennenswert verschieben. Es ist ein „das sollte man sich ansehen“, kein Alarmsignal. Was Sie damit tun: zurück zum Chargenprotokoll dieses Laufs, prüfen, ob die Temperatur wirklich gehalten hat, ob die Probe rechtzeitig gezogen wurde, ob der Assay reinjiziert wurde. Ist der Lauf sauber, behalten Sie ihn. Löschen Sie nie einen Punkt, nur weil eine Statistik ihn markiert hat und das Protokoll nichts Auffälliges zeigt.
Wie Sie Shapiro-Wilk W = 0,888, p = 0,036 lesen
Der Test verwirft Normalität. Bevor Sie Ihre Antwortgröße transformieren, sollten Sie drei Dinge wissen.
Erstens: n = 18. Shapiro-Wilk bei 18 Residuen hat geringe Power gegenüber echten Abweichungen und ist verrauscht gegenüber harmlosen. Ein p knapp unter 0,05 bei 18 Punkten ist schwache Evidenz, kein Urteil.
Zweitens: Bei einem R-Quadrat von 0,9988 sind die Residuen winzig. Was übrig bleibt, ist fast reines Messrauschen plus der kleine systematische Anteil, den die quadratische Form nicht abfangen kann. Ein einzelnes mäßig großes Residuum kann W nach unten ziehen, ohne dass eines der Residuen in für Sie relevanten Einheiten groß wäre.
Drittens, und am nützlichsten: Lesen Sie die Normalitätsmarkierung *zusammen* mit der Cooks-D-Markierung. Beide zeigen auf denselben Bereich des Designs. Das ergibt ein konsistentes Bild: Ein Lauf liegt leicht neben der Fläche, und es ist derselbe Lauf, der Cooks D aufbläht und die Residuen nicht normalverteilt aussehen lässt. Eine Erklärung, zwei Symptome. Das ist deutlich informativer als eine der beiden Zahlen allein.
Praktische Reaktion, der Reihe nach:
1. Prüfen Sie das Chargenprotokoll des markierten Laufs. 2. Fitten Sie ohne ihn neu und vergleichen Sie Koeffizienten und die Lage des Optimums. Verschiebt sich nichts, ist die Markierung kosmetisch. 3. Nur wenn die Residuenstreuung mit dem gefitteten Wert wächst, sollten Sie eine varianzstabilisierende Transformation (log, Quadratwurzel) oder gewichtete kleinste Quadrate in Betracht ziehen. 4. Ist im Plot der Residuen gegen die gefitteten Werte noch Krümmung sichtbar, ist die Modellform falsch, nicht die Daten. Fügen Sie Terme hinzu, oder verkleinern Sie den modellierten Bereich.
Was diese Diagnostik nicht aussagt
- Sie können das Modell nicht außerhalb des Designbereichs validieren. Jede Statistik hier ist bedingt durch die tatsächlich gefahrenen Bereiche. Extrapolation ist ungeschützt.
- Sie können nicht sagen, dass ein markierter Lauf eine schlechte Messung ist. Das können nur das Chargenprotokoll und der Analyst. Statistiken identifizieren Kandidaten für die Überprüfung.
- Normalität der Residuen ist nicht Normalität der Antwortgröße. Transformieren Sie die Antwortgröße nicht, nur weil die rohen Ausbeuten schief aussehen.
- Ein sauberes Diagnostik-Panel ist kein validierter Prozess. Es sagt, dass die Regressionsannahmen vertretbar sind. Es sagt nichts über Robustheit, Scale-up oder ob Ihr Assay für den Zweck geeignet ist.
- Das sind Ergebnisse zur Entscheidungsunterstützung, keine Einreichung. Sie gehören als unterstützende Evidenz in Ihren Entwicklungsbericht, neben Laborbestätigungsläufen.
Häufige Fragen
Was ist ein guter Cooks-Distanz-Grenzwert für ein geplantes Experiment?
Zwei Grenzwerte sind Standard. Das sensitive Screening ist 4/n, also 0,222 für ein 18-Lauf-Design. Der klassische Einfluss-Grenzwert ist D größer als 1. Ein Wert dazwischen, wie die 0,277 bei Lauf 9 im Praxisbeispiel, bedeutet, dass der Lauf einen Blick ins Chargenprotokoll verdient, das gefittete Modell aber bei Entfernung nicht nennenswert verändern würde. Löschen Sie nie einen Lauf allein aufgrund der Statistik.
Warum haben axiale Punkte in einem Central Composite Design hohe Leverage?
Axiale oder Sternpunkte liegen weiter vom Designzentrum entfernt als jede faktorielle Ecke, bei alpha = 2,236 wie in diesem CCD. Leverage wächst mit dem Abstand vom Zentroid, sodass die axialen Läufe hier die höchsten Hat-Werte tragen. In einem echten 18-Lauf-CCD lag das bei 0,733 für axiale Punkte gegenüber 0,206 für Zentrumspunkte. Das ist so gewollt: Axiale Läufe sind es, die überhaupt erst erlauben, die reinen quadratischen Terme zu schätzen.
Macht ein fehlgeschlagener Shapiro-Wilk-Test mein Response-Surface-Modell ungültig?
Nicht für sich allein. Bei kleinen geplanten Experimenten hat der Test begrenzte Power, und ein grenzwertiger p-Wert trägt wenig Gewicht. Ein echter Fit im Praxisbeispiel lieferte W = 0,888 bei p = 0,036 auf 18 Residuen mit R-Quadrat 0,9988. Der praktische Schritt ist, zu prüfen, ob derselbe Lauf auch die Cooks Distanz in die Höhe treibt, die Residuen gegen die gefitteten Werte auf Struktur zu untersuchen und die Antwortgröße nur zu transformieren, wenn die Varianz eindeutig mit dem gefitteten Wert skaliert.
Wie viele Residuen braucht Shapiro-Wilk, um aussagekräftig zu sein?
Shapiro-Wilk ist ab etwa n = 7 nutzbar, hat aber unterhalb von etwa n = 30 schwache Power. Typische DoE-Größen, 12 bis 20 Läufe, liegen genau in diesem Bereich schwacher Power. Das heißt, ein Bestehen ist schwache Beruhigung, und ein grenzwertiges Nichtbestehen ist schwacher Beweis für ein Problem. Nutzen Sie den Test als einen Baustein neben Residuenplots und Cooks Distanz, nicht als alleiniges Entscheidungskriterium.
Was ist der Unterschied zwischen Leverage und Einfluss?
Leverage ist eine Eigenschaft allein der Designmatrix: wie weit ein Lauf vom Zentrum des Faktorraums entfernt liegt. Sie ist bekannt, bevor überhaupt gemessen wird. Einfluss, gemessen durch Cooks Distanz, kombiniert Leverage mit der Frage, wie schlecht dieser Lauf gefittet ist. Ein Lauf mit hoher Leverage, der genau auf der Fläche liegt, hat kaum Einfluss. Einfluss entsteht erst, wenn eine ungewöhnliche Faktoreinstellung auch eine unerwartete Antwort erzeugt.
Kann Residualdiagnostik eine falsche Modellform erkennen?
Teilweise. Systematische Krümmung im Plot der Residuen gegen die gefitteten Werte deutet auf fehlende Terme hin, und Lack-of-Fit-Tests gegen replizierte Zentrumspunkte prüfen das direkt. Aber Shapiro-Wilk und Cooks Distanz allein unterscheiden nicht zwischen einem fehlenden Interaktionsterm und Messrauschen. Untersuchen Sie immer die Residuenplots, und nutzen Sie replizierte Zentrumspunkte, damit ein formaler Lack-of-Fit-Test verfügbar ist.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- Design-of-Experiments, RSM, Templates.