

Sie haben vier Prozessparameter und ein Kontrollbudget, das vielleicht für einen davon wirklich ausreicht. Eine enge Temperaturkontrolle kostet Mantelkapazität und eine PAT-Sonde; eine enge Katalysatordosierung kostet eine Wägestation und einen zusätzlichen Bedienschritt. Die Frage, die entscheidet, wohin das Geld fließt, lautet nicht „welcher Parameter wichtig ist“, sondern „welcher Parameter die Variation erklärt, die Sie tatsächlich beobachten“.
Haupteffekt-Diagramme und One-Factor-at-a-Time-Screening beantworten das nicht. Sie bewerten jeden Faktor, während alle anderen auf einem Nominalwert stehen, also in genau dem einen Betriebszustand, den Ihre Anlage so nie fährt.
Die drei Methoden, die gemeint sind, wenn von „Sensitivität“ die Rede ist
Sie berechnen unterschiedliche Dinge. Wird die falsche Methode gewählt, wird ein Faktor als unkritisch eingestuft und verursacht zwei Jahre später eine Abweichung.
| Methode | Was sie misst | Aufwand | Interaktionen | Braucht ein Modell |
|---|---|---|---|---|
| Morris (Elementary Effects) | Screening-Ranking: mittlerer absoluter Effekt (mu*) und seine Streuung (sigma) über viele zufällige Punkte im Faktorraum | Niedrig | Erkennt sie (hohes sigma), quantifiziert sie nicht | Nein, arbeitet auf der Prozessfunktion oder einem Surrogat |
| Sobol (Varianzzerlegung) | Der Anteil der Ausgangsvarianz, der jedem Faktor allein (S1) und einschließlich aller Interaktionen (ST) zuzuschreiben ist | Hoch: tausende Auswertungen | Ja, quantifiziert und trennbar | Praktisch ja, braucht ein schnelles Surrogat |
| SHAP | Zuordnung einer einzelnen Vorhersage zu jedem Eingabemerkmal, gemittelt für eine globale Sicht | Moderat | Teilweise, über Interaktionswerte | Ja, erklärt das Modell, nicht den Prozess |
Der wichtigste Unterschied:
- Morris und Sobol betreffen den Prozess. Sie tasten den von Ihnen definierten Faktorraum ab und fragen, wie sich die Antwort bewegt. Morris erstellt eine Rangfolge; Sobol verteilt die Varianz.
- SHAP betrifft das Modell. Es zeigt, worauf das gefittete Modell seine Vorhersagen stützt. Ist das Modell falsch, oder sind zwei Faktoren in Ihren Daten konfundiert, gibt SHAP die Modelllogik getreu wieder und führt Sie beim Prozess in die Irre.
Eine praktikable Reihenfolge: Morris zum günstigen Screening und Ranking, Sobol für die verbliebenen Faktoren, wenn eine belastbare Varianzaufteilung gebraucht wird, SHAP, wenn das Modell selbst befragt werden soll. Die Sobol-Total-Order-Indizes (ST) sind das, was Sie zitieren, wenn ein Prüfer fragt, wie viel CQA-Varianz ein Parameter für sich beansprucht.
Morris liefert außerdem das Verhältnis von sigma zu mu* quasi nebenbei mit. Hohes mu* bei niedrigem sigma bedeutet, dass der Faktor linear und additiv wirkt. Hohes mu* bei hohem sigma bedeutet, dass der Effekt davon abhängt, wo im Raum Sie sich befinden, ein Hinweis auf eine Interaktion oder Nichtlinearität und ein Signal, genauer hinzuschauen, bevor ein Sollwert festgelegt wird.
Praxisbeispiel: eine Pd-katalysierte Kupplung
Die folgenden Zahlen stammen aus einer Auswertung von CovaSyn auf einem repräsentativen 30-Lauf-Datensatz einer Pd-katalysierten Kupplung (Temperatur, Katalysatorbeladung, Base-Äquivalente, Zeit, gegen Ausbeute und Reinheit). Die Eingangsdaten sind illustrative Prozessdaten, kein konkreter Chargendatensatz eines Kunden. Die Ergebnisse sind unverändert übernommen und reproduzierbar.
Schritt 1: Faktoren in eine Rangfolge bringen
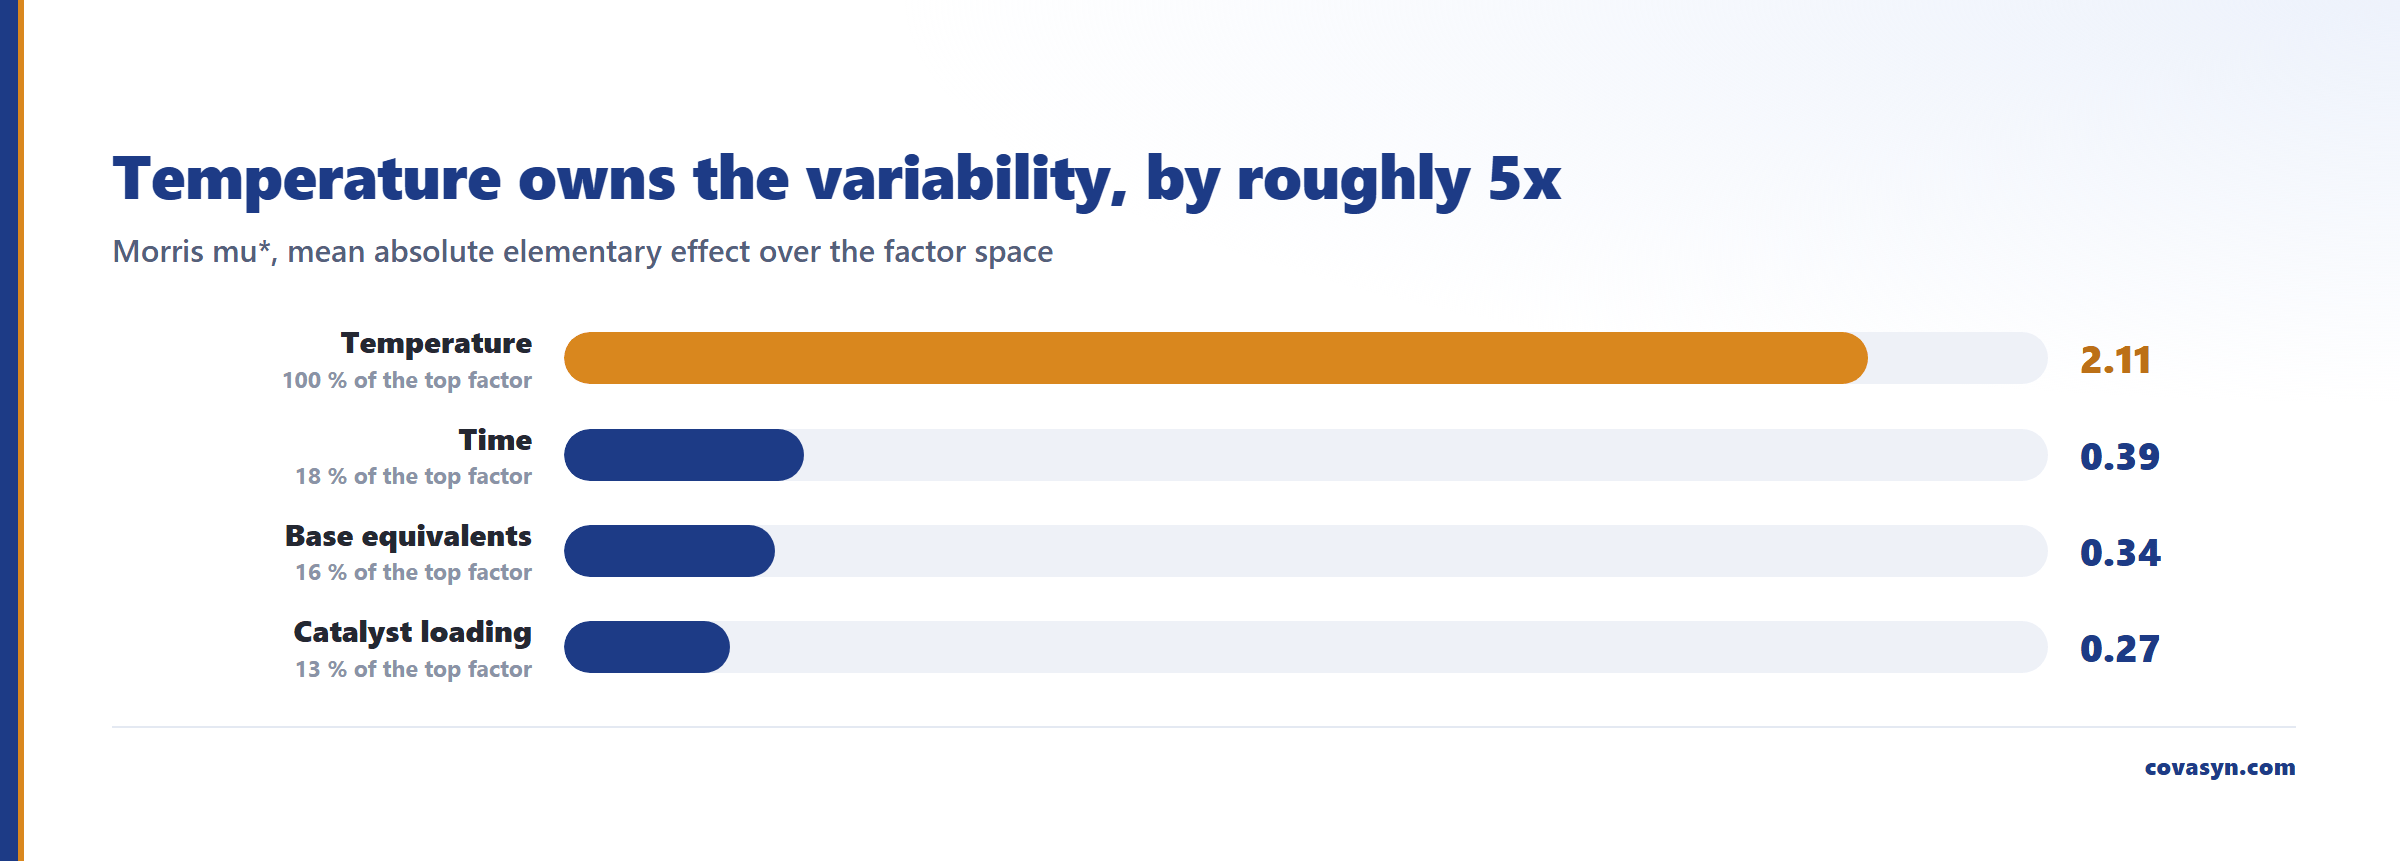
Ein Morris-Screening über die vier Faktoren ergab:
| Faktor | Morris mu* | Relativ zum Höchstwert |
|---|---|---|
| Temperatur | 2,11 | 100 % |
| Zeit | 0,39 | 18 % |
| Base-Äquivalente | 0,34 | 16 % |
| Katalysatorbeladung | 0,27 | 13 % |
Das ist kein knappes Ergebnis. Temperatur trägt etwa das Fünffache des elementaren Effekts des nächsten Faktors. Drei Parameter liegen in einem so engen Band, dass ein Ranking zwischen ihnen bei dieser Stichprobengröße nicht aussagekräftig ist. Selbst das ist ein nützlicher Befund: Stützen Sie kein Kontrollargument darauf, Zeit von Base zu unterscheiden.
Schritt 2: eine zweite Meinung von einer anderen Methode einholen
Ein einzelner Sensitivitätslauf ist die Meinung einer Methode. Die Bayes'sche Parameterwichtigkeit, berechnet aus der Posterior-Verteilung der Optimierung statt aus elementaren Effekten, wies der Temperatur einen Anteil von 0,97 an der Gesamtwichtigkeit zu. Wenn zwei Methoden mit unterschiedlicher mathematischer Grundlage beim selben Faktor landen, ist das der Beleg, den Sie brauchen, bevor Sie „Temperatur ist der CPP“ in eine Kontrollstrategie schreiben.
Wenn zwei Methoden nicht übereinstimmen, ist auch das aufschlussreich und deutet meist auf eine Modellfehlspezifikation hin oder auf einen Faktor, dessen Bereich in Ihren Daten zu eng ist, um die Antwort zu bewegen.
Schritt 3: die Interaktion finden, die das Ranking verbirgt
Ranking ist eine eindimensionale Sicht. Friedmans H-Statistik deckte eine Katalysator-Base-Interaktion von 0,31 auf. Nach Morris mu* ist keiner der beiden Faktoren für sich wichtig, doch gemeinsam sind sie nicht unabhängig. One-Factor-at-a-Time-Screening kann das konstruktionsbedingt nicht sehen, und eine Haupteffekt-Tabelle hätte Ihnen geraten, beide zu ignorieren.
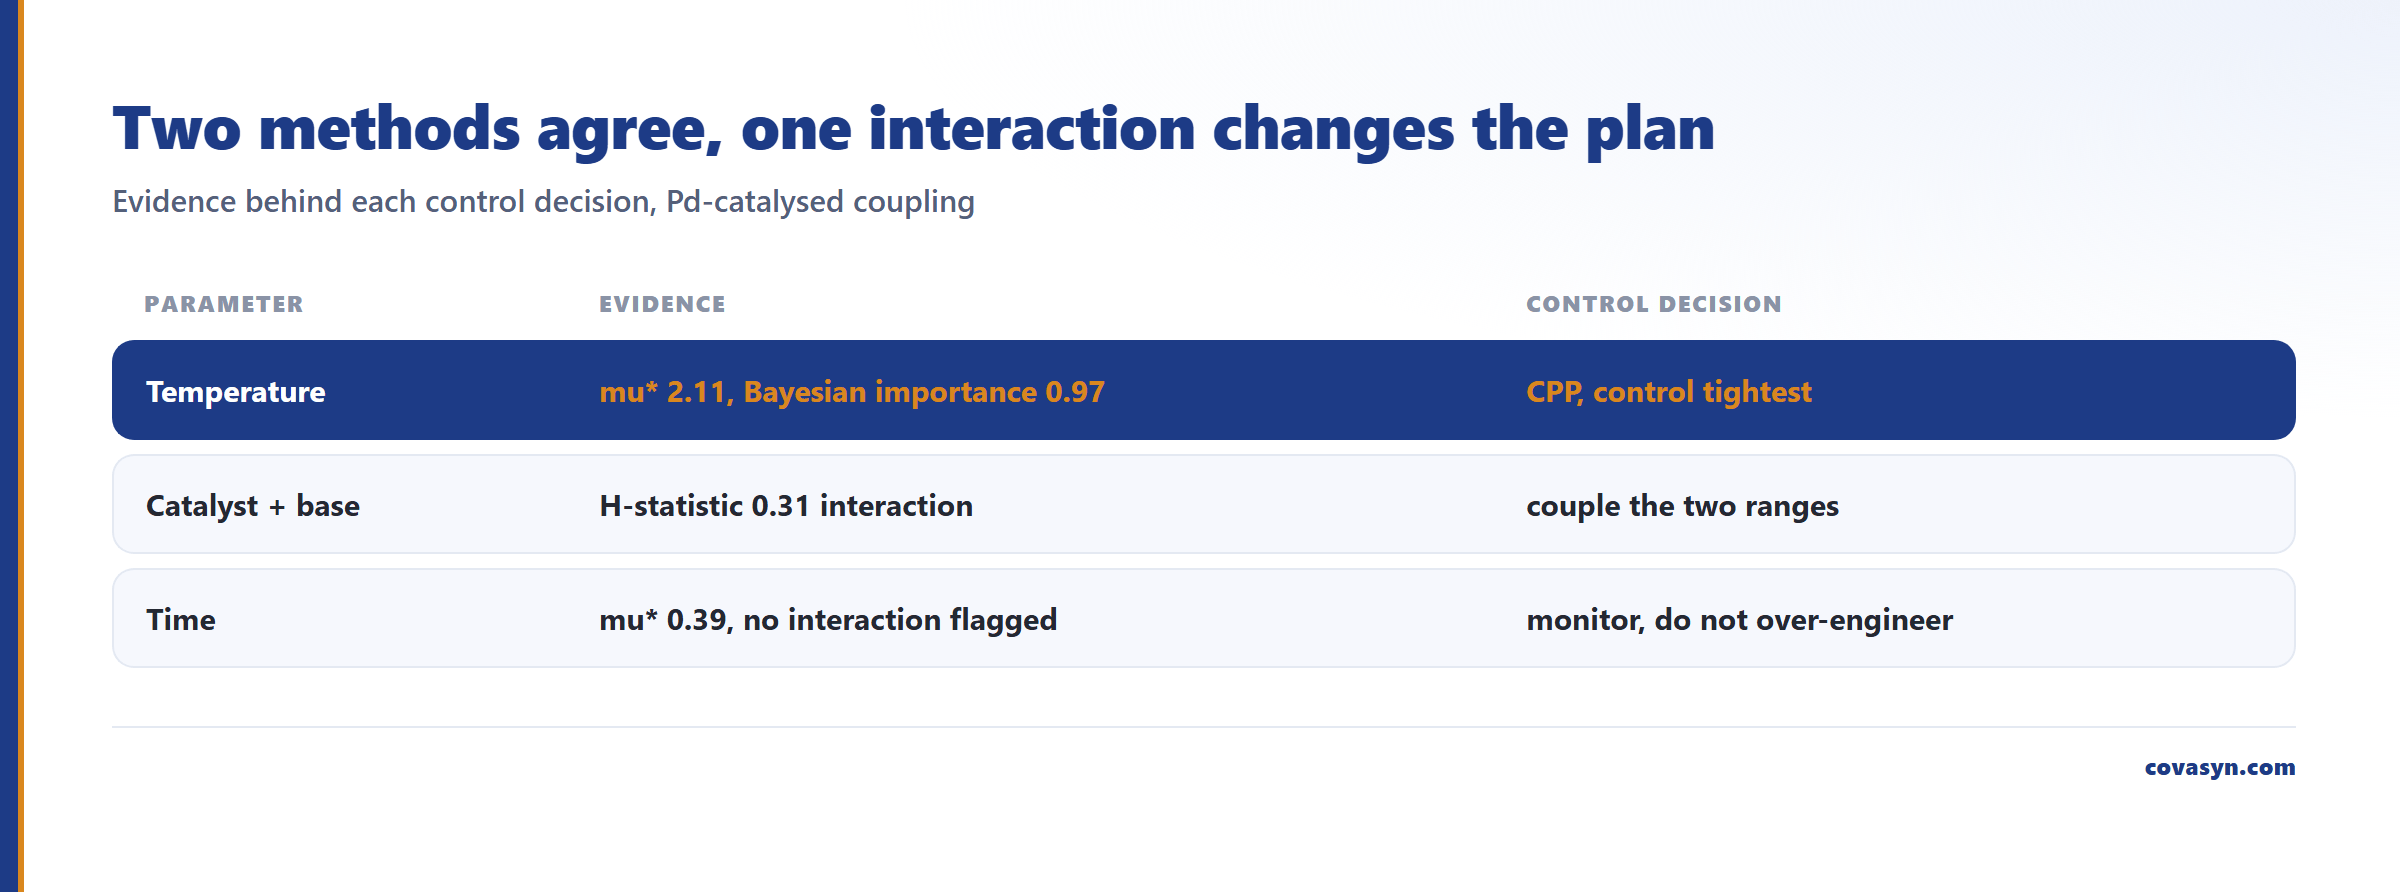
Praktisch heißt das: Wird der Katalysatorbereich erweitert, ändert sich der akzeptable Base-Bereich. Der nachgewiesene akzeptable Bereich des einen hängt vom anderen ab, und das gehört in die Design-Space-Beschreibung statt in zwei getrennte Bereiche.
Schritt 4: das tatsächlich vorhandene Rauschen fortpflanzen
Ranking zeigt, was wichtig ist. Es zeigt nicht, ob Ihre aktuelle Kontrolle gut genug ist. Eine Monte-Carlo-Simulation pflanzte die normale Betriebsvariation am empfohlenen Sollwert über 2000 Ziehungen durch die gefitteten Modelle fort und lieferte eine CQA-Ausfallwahrscheinlichkeit von 0,0.
Lesen Sie das genau. In 2000 Ziehungen wurde kein Ausfall beobachtet; das ist nicht dasselbe wie die Aussage, ein Ausfall sei unmöglich. Die Rule of Three setzt die obere 95-%-Grenze bei etwa 3/2000, also rund 0,15 %. Zudem hängt das Ergebnis von der pro Faktor angenommenen Rauschverteilung ab. Ist Ihre reale Temperaturkontrolle schlechter als angenommen, verschiebt sich die Zahl.
Was sich dadurch in der Kontrollstrategie ändert
Das Ergebnis dieses Workflows ist eine belastbare Zuordnung, kein Bericht:
1. Temperatur: als CPP klassifizieren, am engsten kontrollieren. Zwei unabhängige Methoden stimmen überein, mu* dominiert um das 5-Fache. Hier gehören die PAT-Sonde und die verschärfte Mantelkontrolle hin. 2. Katalysator und Base: als Paar kontrollieren. Die Interaktion mit H-Statistik 0,31 bedeutet, dass ihre Bereiche gekoppelt sind. Definieren Sie sie gemeinsam im Design Space, nicht als unabhängige PARs. 3. Zeit: überwachen, aber nicht überregulieren. mu* 0,39, keine Interaktion festgestellt. Ein breiterer Betriebsbereich ist wahrscheinlich vertretbar, wenn Bestätigungsläufe das stützen.
Für Zwecke nach ICH Q8/Q11 ist das die Evidenz, auf der eine Kritikalitätsbewertung ruhen soll: globale Sensitivität über den gesamten Faktorraum plus quantifizierte Unsicherheit, statt eines Haupteffekt-Diagramms aus einem Screening-Design, abgelesen bei Nominalbedingungen.
Ehrliche Grenzen
- Sensitivität ist durch Ihre Faktorbereiche begrenzt. Morris mu* ist der Effekt *innerhalb des von Ihnen festgelegten Bereichs*. Wird der Temperaturbereich verengt, wirkt Temperatur nicht mehr kritisch. Sie war nie eine Eigenschaft des Parameters allein.
- Darunter liegt ein Surrogatmodell. Morris und Sobol auf einem gefitteten Modell erben dessen Fehler. In diesem Beispiel erreichte das zugrunde liegende Ausbeutemodell ein kreuzvalidiertes Q² von 0,80 und das Reinheitsmodell ein Q² von 0,72. Unterhalb von etwa Q² 0,5 lohnt es sich nicht, Entscheidungen auf das Sensitivitäts-Ranking zu stützen.
- Korrelierte Faktoren brechen die Zuordnung. Wurden Temperatur und Zeit in Ihren historischen Daten gemeinsam variiert, kann keine Methode sie sauber trennen. Geplante Experimente können das; historische Chargenaufzeichnungen oft nicht.
- Nicht gemessene Faktoren erscheinen nicht. Rohstoffcharge, Luftfeuchtigkeit, Bediener und Anlagenzug sind unsichtbar, wenn sie keine Spalten im Datensatz sind. Ein Faktor-Ranking sagt nichts darüber, was Sie nicht erfasst haben.
- Eine Ausfallwahrscheinlichkeit von 0,0 ist ein Simulationsergebnis. Es ist kein validierter Fähigkeitsnachweis und kein Ersatz für Bestätigungsläufe an den Rändern des vorgeschlagenen Bereichs.
- Das sind 30 Läufe. Das Ranking zwischen Zeit, Base und Katalysator (0,39 / 0,34 / 0,27) liegt innerhalb des bei diesem n zu erwartenden Rauschens. Behandeln Sie die Spitze der Liste als Befund, nicht die Reihenfolge im Rest der Liste.
- CovaSyn ist Entscheidungsunterstützung und Triage. Es zeigt, wo experimenteller Aufwand sich lohnt. Es ersetzt keine validierte Laborbestätigung und erzeugt keine Einreichung.
Häufige Fragen
Was ist der Unterschied zwischen Morris- und Sobol-Sensitivitätsanalyse?
Morris-Screening berechnet elementare Effekte an vielen zufälligen Punkten und liefert mu*, einen mittleren absoluten Effekt zur günstigen Rangordnung von Faktoren. Sobol zerlegt die Ausgangsvarianz und liefert den Anteil, den jeder Faktor für sich (First-Order) und einschließlich aller Interaktionen (Total-Order) trägt. Morris ist ein Screening-Werkzeug mit Kosten von zehn bis hundert Auswertungen; Sobol ist ein Quantifizierungswerkzeug mit typischerweise tausenden Auswertungen. Übliche Praxis: zuerst Morris, dann Sobol auf den verbliebenen Faktoren.
Kann ich SHAP zur Identifikation kritischer Prozessparameter nutzen?
SHAP erklärt das gefittete Modell, nicht den Prozess. Es ordnet jede Vorhersage Eingabemerkmalen zu und eignet sich hervorragend, um zu prüfen, ob ein Modell etwas chemisch Sinnvolles gelernt hat. Sind zwei Parameter in Ihren historischen Daten jedoch korreliert, verteilt SHAP die Zuschreibung entsprechend dem, was das Modell genutzt hat; das muss nicht dem kausalen Prozesseinfluss entsprechen. Nutzen Sie SHAP, um das Modell zu prüfen, und Morris oder Sobol auf einem abgetasteten Faktorraum, um CPPs zu klassifizieren.
Wie viele Läufe brauche ich für eine aussagekräftige Sensitivitätsanalyse?
Die Sensitivitätsanalyse läuft auf einem gefitteten Modell, die Anforderung ist also ein Modell, das gut genug ist, um ihm zu vertrauen. Ein praktikabler Schwellenwert ist ein kreuzvalidiertes Q² über etwa 0,5, wobei 0,7 oder besser bevorzugt wird. Das Praxisbeispiel nutzte 30 Läufe und erreichte Q² 0,80 für die Ausbeute. Darunter spiegelt das Ranking eher Modellfehler als Prozessverhalten wider, und die richtige Reaktion sind mehr Experimente statt mehr Analyse.
Was bedeutet Morris mu* eigentlich?
mu* ist der Mittelwert der absoluten elementaren Effekte: die durchschnittliche Größe der Antwortänderung, wenn dieser Faktor variiert wird, gemessen über viele zufällige Startpunkte im Faktorraum. Es ist eine Rangordnungsstatistik, kein Prozentsatz. Ein mu* von 2,11 für Temperatur gegenüber 0,39 für Zeit bedeutet, dass Temperatur die Antwort im Durchschnitt etwa fünfmal so stark bewegt, in den Einheiten der Antwort, über die von Ihnen definierten Bereiche.
Bedeutet ein niedriger Sensitivitätswert, dass ein Parameter unkritisch ist?
Nicht für sich allein. Niedrige Sensitivität bedeutet geringen Einfluss innerhalb des getesteten Bereichs, eine Aussage über Ihren Bereich ebenso wie über den Parameter. Prüfen Sie auch die Interaktionsterme: Im Praxisbeispiel erzielten Katalysator und Base einzeln jeweils niedrige Werte (mu* 0,27 und 0,34), zeigten aber eine reale Katalysator-Base-Interaktion mit H-Statistik 0,31. Ein Parameter kann allein unkritisch und in Kombination kritisch sein.
Wie unterstützt das eine Kritikalitätsbewertung nach ICH Q8?
Es liefert globale Sensitivität über den gesamten multivariaten Faktorraum plus quantifizierte Unsicherheit am vorgeschlagenen Sollwert. Genau das braucht ein Kritikalitätsargument, um mehr als eine Meinung zu sein. Für sich allein stellt es die Bewertung nicht dar. Sie brauchen weiterhin die Risikobewertung, Bestätigungsläufe an den Bereichsrändern und eine Kontrollstrategie, die jeden klassifizierten CPP mit einer konkreten Kontrolle verknüpft.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- Mehrziel-Optimierung, Robustheit, Drift.