

Sie haben einen neuen Verunreinigungspeak bei 4,1 min und drei Kandidatenstrukturen aus der Syntheseroute. Niemand möchte drei Referenzstandards bestellen, um herauszufinden, welche es ist. Die naheliegende Frage ist, ob ein Computer sagen kann, wo jede Kandidatenstruktur eluieren sollte, und ob diese Antwort gut genug ist, um danach zu handeln.
Kurz gesagt: Retentionszeit-Vorhersage ist nützlich, um Peaks zu ordnen und Kandidatenlisten einzugrenzen. Sie ist nicht nützlich, um Integrationsfenster oder Akzeptanzkriterien festzulegen. Dieser Artikel zeigt genau, wo diese Grenze verläuft, anhand echter Vorhersagen aus der Retentionszeit-Vorhersage von CovaSyn.
Was Retentionszeit-Vorhersage tatsächlich tut
Reversed-Phase-Retention auf einer C18-Säule wird von der Hydrophobie dominiert. Das Linear-Solvent-Strength-Modell (LSS) drückt das aus als log k = log k_w − S · phi, wobei k der Retentionsfaktor ist, phi der organische Anteil, k_w die extrapolierte Retention in reinem Wasser und S eine Steigung, die grob mit der Molekülgröße skaliert.
Eine Vorhersage schätzt k_w und S aus der Struktur und rechnet das resultierende k dann mit der Säulen-Totzeit t0 in eine Retentionszeit um. Das ist der gesamte Mechanismus. Alles andere ist ein Weg, k_w und S besser zu schätzen, als es eine reine logP-Korrelation kann.
Das ist wichtig, weil es sofort zeigt, was die Vorhersage wissen kann und was nicht. Sie kennt die Hydrophobie. Sie kennt nicht Ihre konkrete Kieselgel-Charge, Ihr Dwell-Volumen, den Effekt Ihres Puffers auf einen teilweise ionisierten Analyten oder ob der Peak auf eine sekundäre Wechselwirkung mit residualen Silanolgruppen zurückgeht.
Drei Aufgaben, für die sie tatsächlich gut geeignet ist
Peak-Tracking über Methodenänderungen hinweg.
Wenn Sie den Gradienten ändern oder von einer 4,6-mm- zu einer 2,1-mm-Säule wechseln, bewegen sich Peaks und können die Reihenfolge tauschen. Eine Vorhersage gibt Ihnen eine Vorab-Erwartung der Reihenfolge, sodass Sie prüfen können, ob Ihre Tracking-Annahme standhält.
Triage bei der Verunreinigungszuordnung.
Sie haben einen Peak und fünf plausible Strukturen aus der Route oder aus einer Stressbelastung. Die Vorhersage benennt selten die Verbindung, eliminiert aber routinemäßig Kandidaten, die in einer völlig anderen Region eluieren sollten. Das spart Käufe von Referenzstandards.
Erste Methodenabschätzung.
Bevor Sie ein Gerät anfassen, sagt Ihnen eine geschätzte Elutionsspreizung, ob ein 15-min-Gradient ungefähr richtig ist oder ob sich die Hälfte Ihrer Analyten im Totvolumen stapelt.
Beachten Sie, dass alle drei Ordnungsprobleme sind, keine Messprobleme.
Durchgerechnetes Beispiel: ein Panel verwandter Substanzen von Paracetamol
Wir haben die Retentionszeiten für ein Paracetamol-Verunreinigungspanel plus Referenzanalyten vorhergesagt und dazu berechnete logP-Werte gestellt. Jede Zahl unten stammt unverändert aus unserer Berechnung vom 15.07.2026.
Für alle Analyten gilt derselbe angenommene Methodenkontext: generische C18-Säule (150 × 4,6 mm), mobile Phase ACN/H2O, Fluss 1,0 mL/min.
| Analyt | Rolle | berechnetes logP | Vorhergesagte RT (min) | Konfidenz |
|---|---|---|---|---|
| Koffein | Referenz, polar | −1,03 | 2,0 | 0,8 |
| 4-Aminophenol | Ph. Eur. Verunreinigung K | 0,97 | 3,2 | 0,8 |
| Paracetamol | API | 1,35 | 3,2 | 0,8 |
| 4-Acetamidophenylacetat | Prozessverunreinigung | nicht gemessen | 3,2 | 0,8 |
| Hydrochinon | Abbauprodukt | nicht gemessen | 3,3 | 0,8 |
| 4-Nitrophenol | Ph. Eur. Verunreinigung F | nicht gemessen | 3,3 | 0,8 |
| Benzoesäure | Referenz, sauer | nicht gemessen | 3,5 | 0,8 |
| 4-Chloracetanilid | Ph. Eur. Verunreinigung J | 2,30 | 4,2 | 0,8 |
| Ibuprofen | Referenz, lipophil | nicht gemessen | 5,0 | 0,8 |
| Stearinsäure | Referenz, sehr lipophil | nicht gemessen | 16,5 | 0,8 |
Als passende Startmethode für Paracetamol ergab unsere Auswertung: Wasser + 0,1 % TFA / Acetonitril, Gradient 10 % B bei 0 min, 20 % B bei 2 min, 60 % B bei 12 min, Halt bis 15 min, 1,0 mL/min.
So lesen Sie diese Tabelle wie ein Praktiker
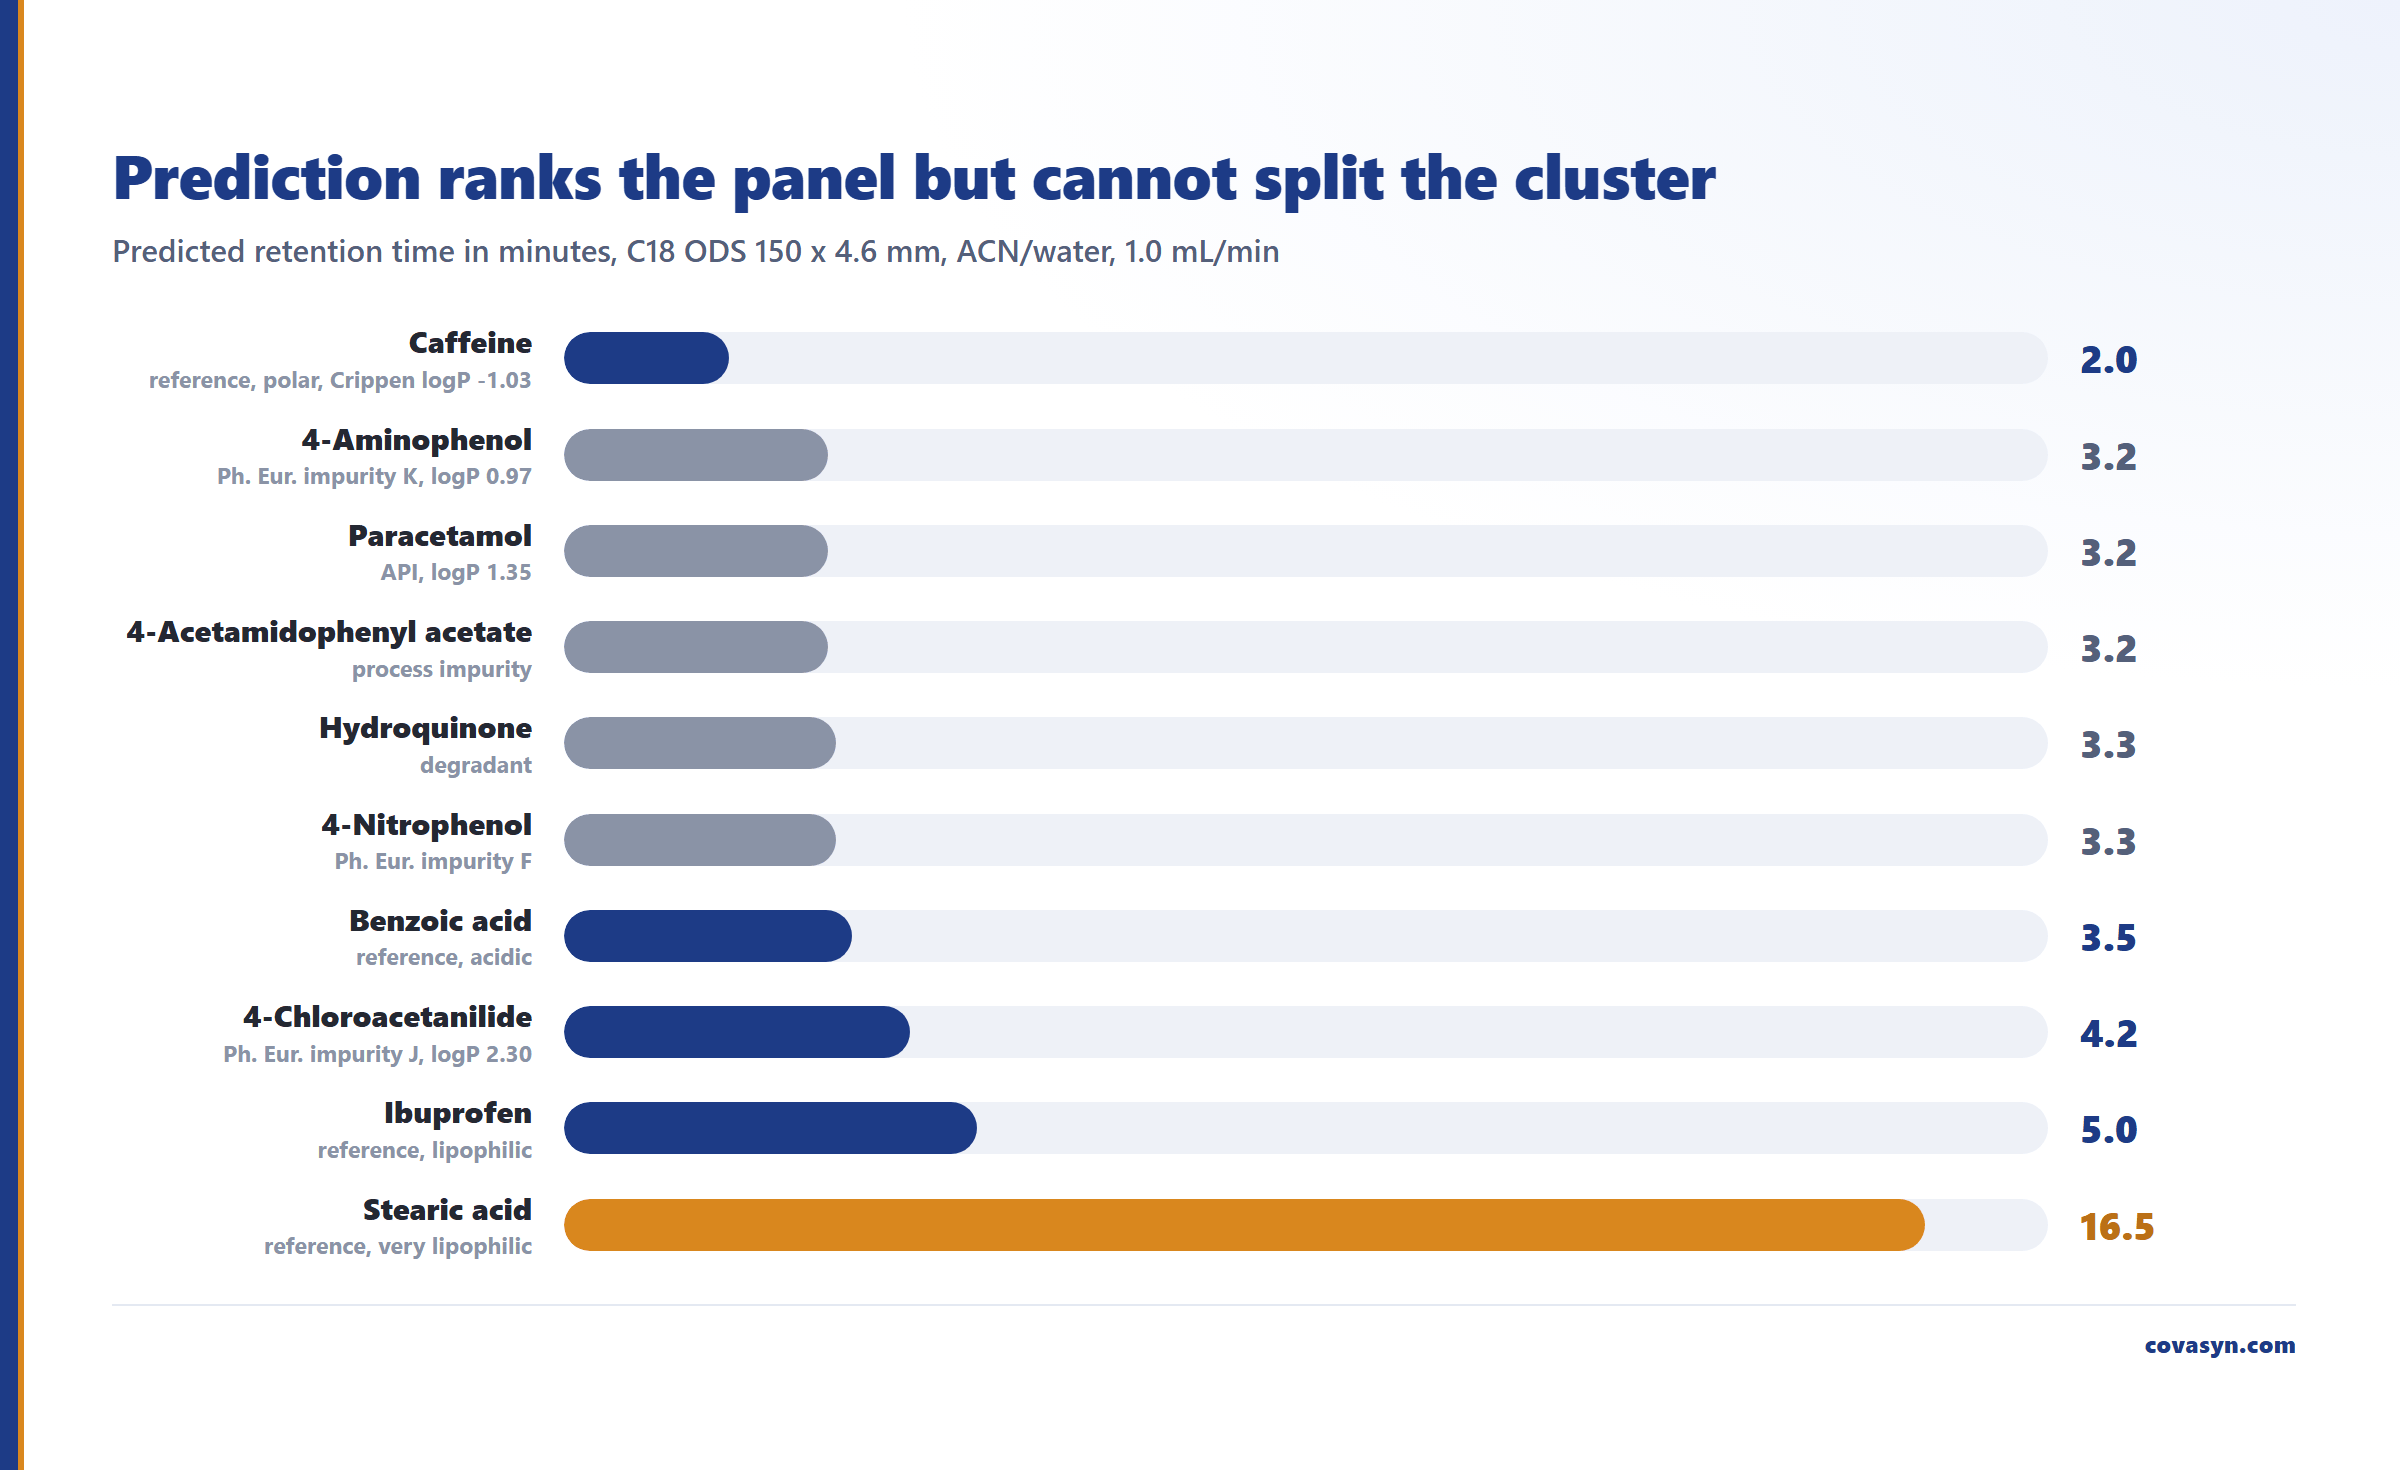
Das nützliche Signal ist die Reihenfolge über den weiten logP-Bereich. Koffein (logP −1,03) bei 2,0 min, der Acetanilid-Cluster um 3,2 bis 4,2 min, Ibuprofen bei 5,0 min, Stearinsäure bei 16,5 min. Diese Rangfolge ist korrekt, und sie ist das, was Sie zur Abschätzung und zur Eliminierung von Kandidaten nutzen.
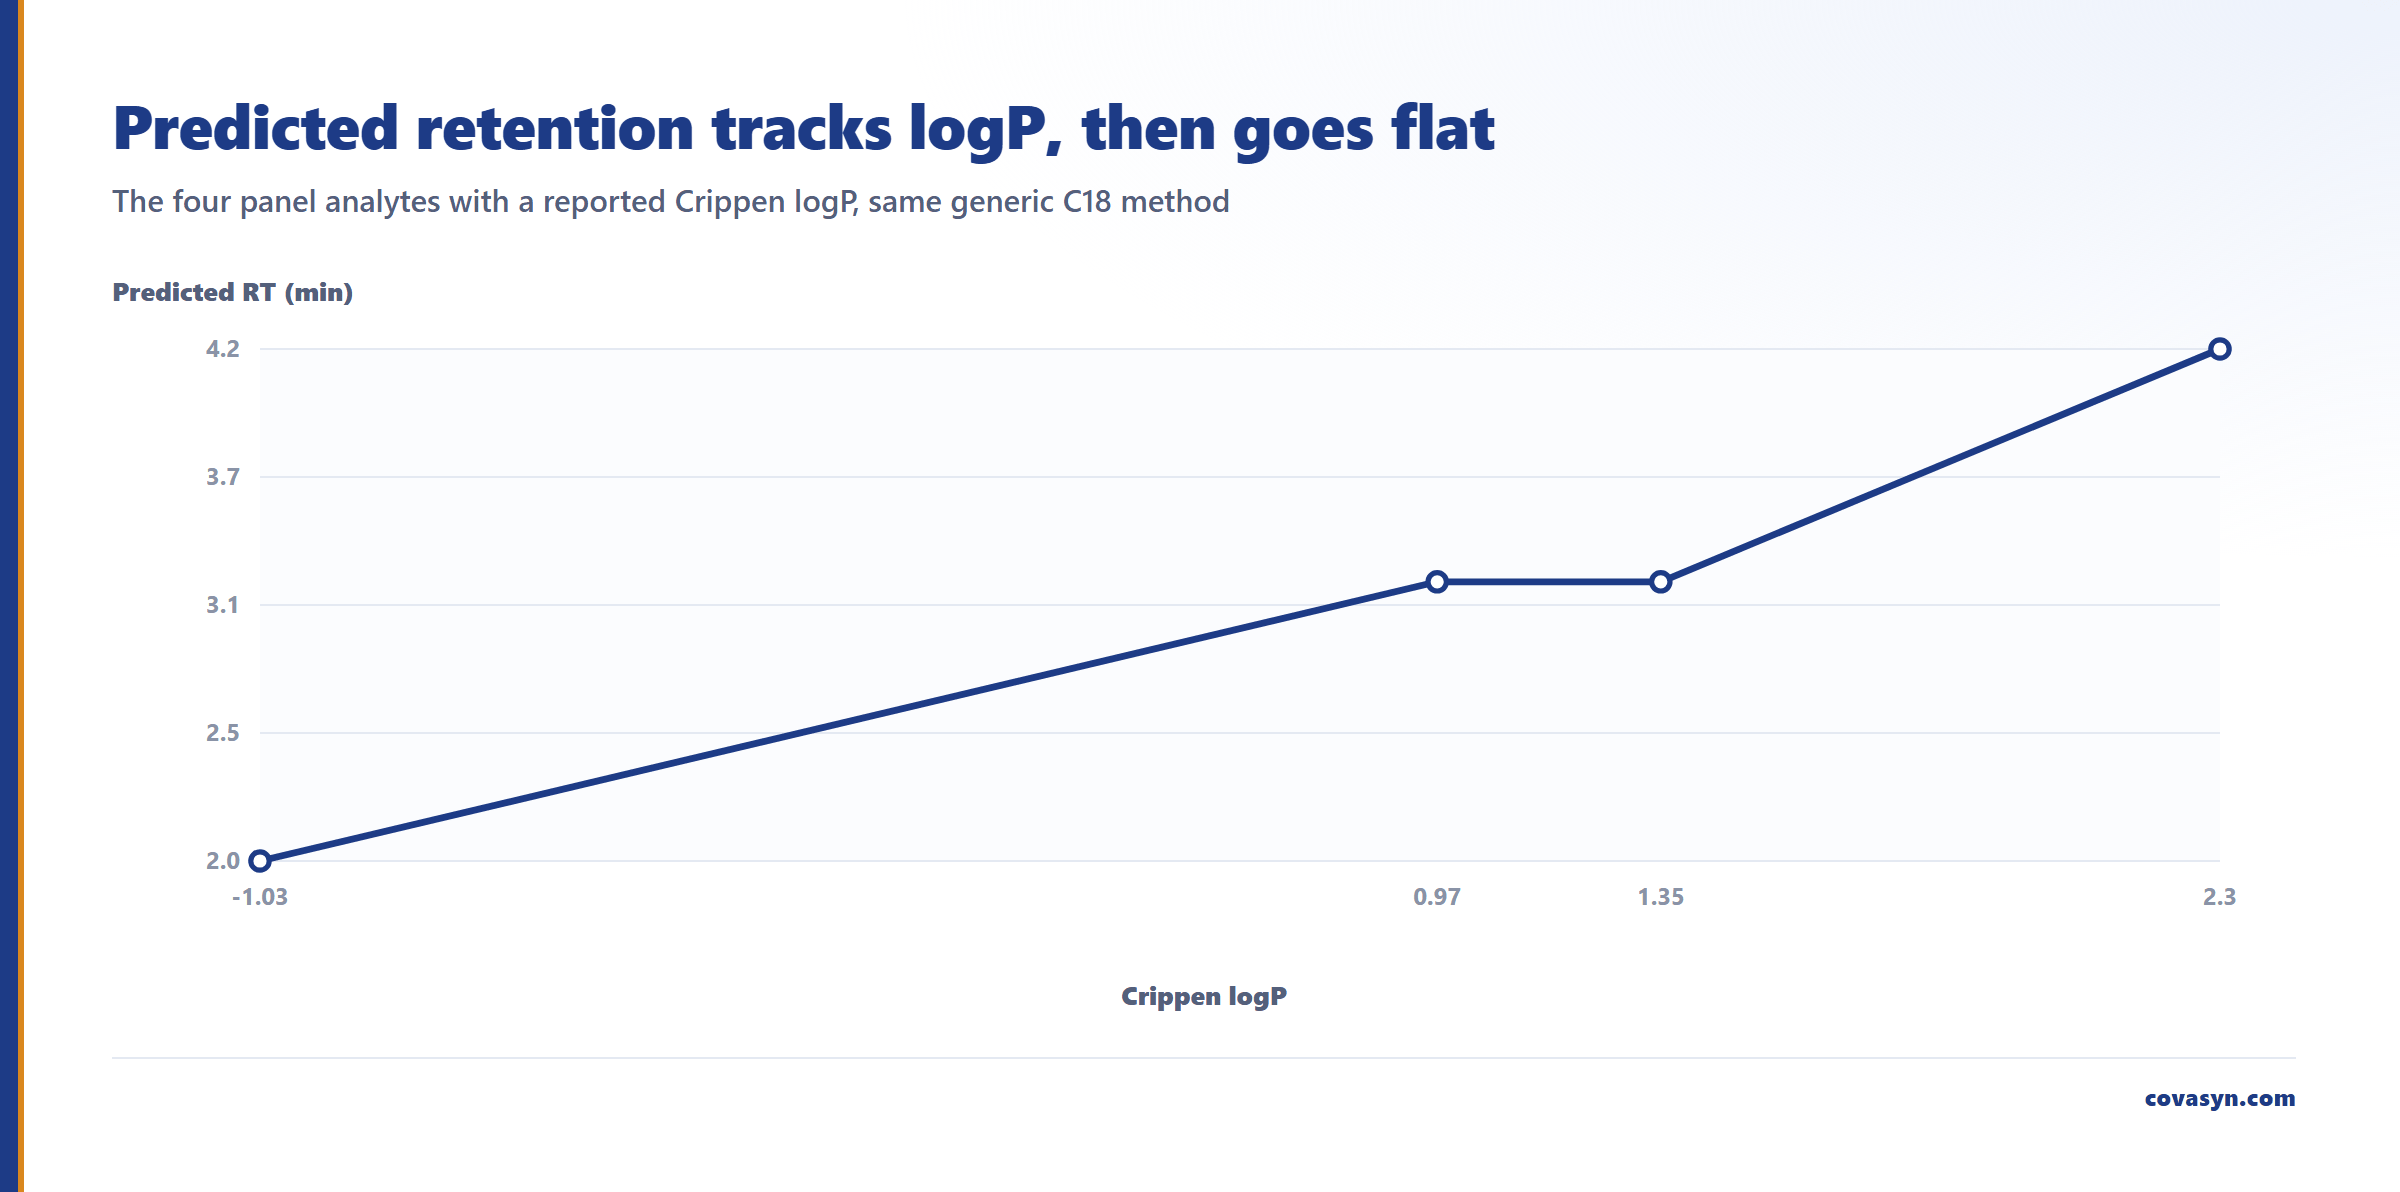
Der unbrauchbare Teil ist die Auflösung innerhalb des Clusters. Paracetamol und 4-Aminophenol kommen beide bei 3,2 min zurück. Auf einem echten Ph.-Eur.-Gradienten für verwandte Substanzen eluiert 4-Aminophenol deutlich vor Paracetamol, weil es wesentlich polarer und bei niedrigem pH teilweise protoniert ist. Das Modell hat einen Unterschied komprimiert, den eine echte Methode leicht trennt. Fünf Analyten bei 3,2 bis 3,3 min bedeuten, dass das Modell sie nicht in eine Rangfolge bringen kann, nicht, dass sie koeluieren.
Was die konstante Konfidenz von 0,8 bedeutet
Jede Vorhersage lieferte dieselbe Konfidenz von 0,8. Das ist kein Zufall und keine validierte Genauigkeitszahl. Ein über das ganze Panel identischer Wert zeigt, dass für keinen dieser Analyten verbindungsspezifische Evidenz vorlag.
Im Klartext: Sie sehen eine allgemeine Hydrophobie-Schätzung nach dem LSS-Prinzip, keine Vorhersage aus Daten zu genau diesen Verbindungen. Behandeln Sie eine durchgängig flache Konfidenz über ein Panel als Warnhinweis, dass das Modell keine verbindungsspezifische Evidenz hatte, nicht als Qualitätskennzahl.
Ehrliche Grenzen: was das nicht verrät
- Es ist keine kalibrierte Retentionszeit. Die zurückgegebene RT ist eine isokratisch-äquivalente Schätzung bei festen generischen Standardbedingungen, umgerechnet mit einer festen Totzeit. Der vorgeschlagene Gradient ist eine separate Empfehlung. Erwarten Sie nicht, dass der gemeldete Minutenwert auf Ihrem Chromatogramm erscheint.
- Es löst keine engen Paare auf. Alles innerhalb von etwa ± 1 min in der aktuellen Ausgabe sollten Sie als eine ungeordnete Gruppe behandeln.
- Ionisierung wird nur grob gehandhabt. Für Säuren und Basen nahe dem pH der mobilen Phase hängt die reale Retention stark von Puffer-pH und Ionenstärke ab. Eine reine Strukturvorhersage liegt hier am häufigsten falsch.
- Kein säulenspezifischer Transfer. Die Vorhersage setzt eine generische C18-Säule (150 × 4,6 mm) voraus und modelliert nicht Ihre spezifische stationäre Phase, Endcapping oder Silanolaktivität.
- Es kann nichts identifizieren. Eine Retentionsübereinstimmung ist mit einer Zuordnung vereinbar. Sie ist niemals ein Beweis dafür. Bestätigung braucht MS, NMR oder einen Referenzstandard.
- Das ist Entscheidungsunterstützung, keine validierte Methode. Nichts hier ersetzt eine ICH-Q2(R2)-Methodenvalidierung oder gehört als Identitätsnachweis in eine behördliche Einreichung.
So nutzen Sie es, ohne sich die Finger zu verbrennen
1. Verankern Sie mit Standards, die Sie bereits haben. Fahren Sie zwei oder drei Verbindungen, die Ihren logP-Bereich abdecken, mit Ihrer tatsächlichen Methode und passen Sie die vorhergesagten an die beobachteten Werte an. Nutzen Sie die Anpassung, nicht die Rohvorhersage. 2. Arbeiten Sie mit relativer Retention. RRT gegenüber dem Wirkstoff (API) ist zwischen Systemen weit übertragbarer als absolute RT, und genau das nutzen Arzneibuch-Monographien ohnehin. 3. Nutzen Sie Vorhersagen zum Ordnen, dann bestätigen Sie den besten Kandidaten. Ein statt fünf gekaufter Referenzstandards ist der tatsächliche Nutzen. 4. Behandeln Sie einen flachen Konfidenzwert als „keine verbindungsspezifischen Daten“. Erweitern Sie Ihr Fenster entsprechend. 5. Legen Sie nie ein Integrationsfenster aus einer Vorhersage fest. Legen Sie es aus injiziertem Material fest.
Zur Einordnung, was am Stand der Technik erreichbar ist: Der größte öffentliche Retentionsdatensatz, METLIN SMRT, enthält rund 80.000 kleine Moleküle, alle auf einem einzigen Reversed-Phase-System gemessen. Darauf trainierte Modelle liefern auf diesem System gute Ergebnisse und verschlechtern sich beim Transfer auf eine andere Säule und einen anderen Gradienten. Der Transfer zwischen chromatographischen Systemen, nicht die reine Modellkapazität, ist der eigentliche Engpass in diesem Gebiet. Jedes Verfahren, das systemunabhängige Minutengenauigkeit verspricht, übertreibt.
Eine Vorhersage ist zudem nur so nützlich wie die Säule, die sie voraussetzt. Passt die Phasenchemie nicht zum Molekül, rettet kein Retentionsmodell die Methode. Klären Sie das deshalb zuerst, mit der Übersicht und dem Entscheidungsbaum zur HPLC Säulenauswahl.
Häufige Fragen
Wie genau ist Retentionszeit-Vorhersage in der HPLC?
Die Genauigkeit hängt vollständig davon ab, ob das Modell auf Ihrem chromatographischen System kalibriert wurde. Reine Strukturvorhersagen wie die von CovaSyn ordnen Analyten über einen weiten Hydrophobiebereich verlässlich, komprimieren aber enge Paare: In unserem Paracetamol-Panel lieferten Paracetamol und 4-Aminophenol beide 3,2 min, obwohl sie in der Praxis sauber trennen. Nutzen Sie Vorhersagen für die Elutionsreihenfolge und kalibrieren Sie dann gegen zwei oder drei echte Standards auf Ihrer eigenen Methode.
Kann man die Retentionszeit aus einem SMILES-String vorhersagen?
Ja, das ist die übliche Eingabe. Aus der Struktur ergeben sich eine vorhergesagte Retentionszeit, ein Konfidenzwert und die angenommene Säule und mobile Phase. Da nur die Struktur übergeben wird, ist das Ergebnis eine generische C18-Schätzung, keine Vorhersage für Ihr spezifisches Instrument und Ihre Säule.
Wofür wird Retentionszeit-Vorhersage in der Pharmaindustrie tatsächlich genutzt?
Für drei Dinge: Peak-Tracking bei einer Methodenänderung, Triage von Kandidatenstrukturen für einen nicht zugeordneten Verunreinigungspeak und erste Abschätzung der Gradientenlänge, bevor Gerätezeit gebucht wird. Alle drei sind Ordnungsaufgaben. Sie wird nicht genutzt, um Integrationsfenster, Systemeignungskriterien oder Akzeptanzgrenzen für die Identität festzulegen, weil diese gemessene Daten aus validierten Methoden erfordern.
Warum bekommen mehrere Verbindungen dieselbe vorhergesagte Retentionszeit?
Weil das Modell sie allein aus der Struktur nicht unterscheiden kann. Wenn Vorhersagen innerhalb von etwa einer Minute clustern, behandeln Sie diesen Cluster als eine einzige ungeordnete Gruppe statt als Koelutionsvorhersage. Ein konstanter Konfidenzwert über ein Panel (0,8 in unserem Lauf) signalisiert, dass keine verbindungsspezifischen Daten verfügbar waren.
Zählt eine vorhergesagte Retentionszeit als Verunreinigungsidentifikation?
Nein. Eine Retentionsübereinstimmung ist mit einer Zuordnung vereinbar, begründet aber niemals eine. Identifikation braucht orthogonale Bestätigung: Massenspektrometrie, NMR oder Koinjektion mit einem qualifizierten Referenzstandard. Die Vorhersage verringert, wie viele Standards Sie kaufen müssen, indem sie Kandidaten eliminiert, die in einer anderen Region des Chromatogramms eluieren sollten.
Wie mache ich eine Vorhersage auf meine Methode übertragbar?
Rechnen Sie in relative Retention um. Fahren Sie zwei oder drei Ankerverbindungen, die Ihren Lipophiliebereich abdecken, mit Ihrem tatsächlichen Gradienten, passen Sie die vorhergesagten an die beobachteten Retentionszeiten an und drücken Sie alles als RRT gegenüber dem Wirkstoff aus. Arzneibuch-Monographien nutzen RRT bereits genau aus diesem Grund: Sie übersteht Änderungen von Dwell-Volumen, Säulendimensionen und Flussrate weit besser als absolute Minuten.
Weiterführende Artikel
Auswertung zu diesem Thema
Wir werten das für Ihr Labor aus.
- HPLC-Methodenentwicklung: Säule, Gradient, Retentionszeit.
- Grundlagen: Molgewicht, LogP, pKa, SMILES.