Das Wichtigste in Kürze
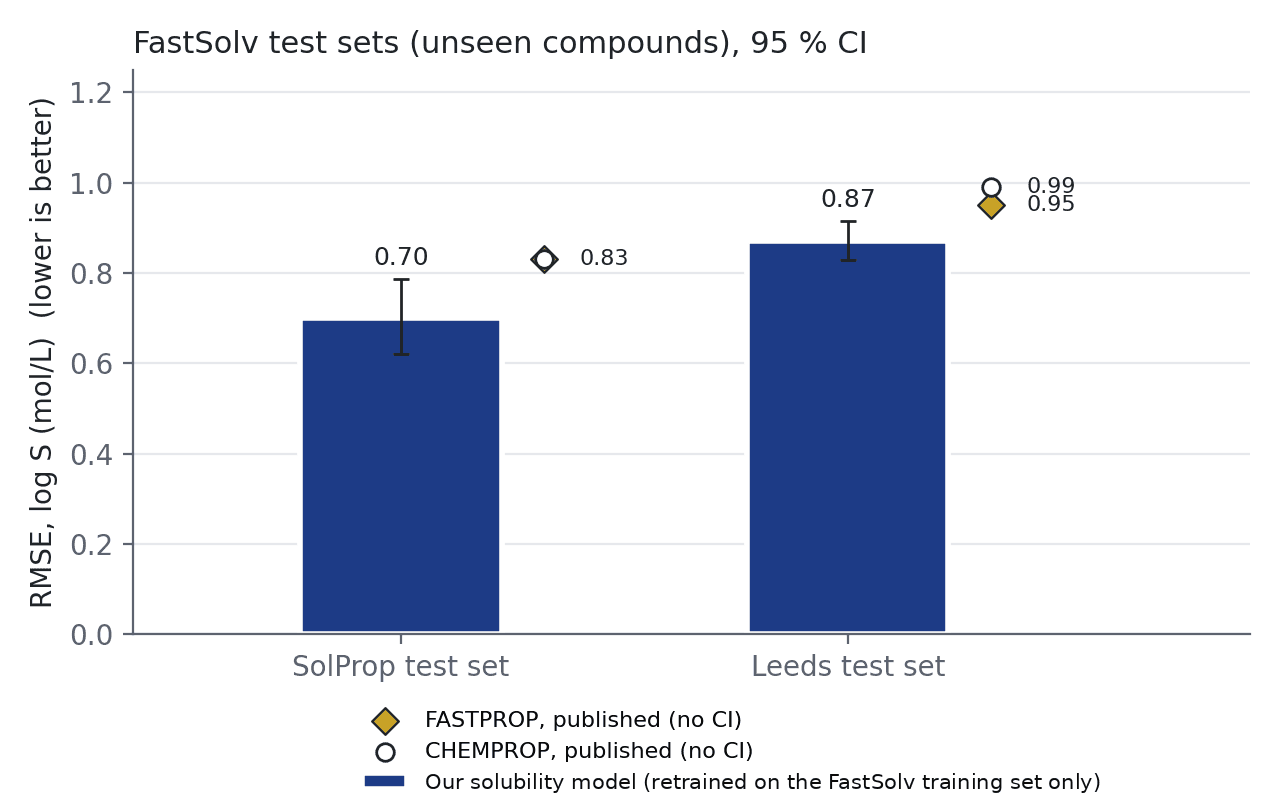
- Auf dem öffentlichen FastSolv-Benchmark (Attia et al., Nat. Commun. 2025) erreicht unser Modell, nur auf den Trainingsdaten des Benchmarks neu trainiert, einen RMSE von 0,70 log-Einheiten auf dem SolProp-Testsatz und 0,87 auf dem Leeds-Testsatz. In beiden Testsätzen kommen die Testverbindungen in den Trainingsdaten nicht vor.
- Das aktuelle Release ist für neue Verbindungen ohne gemessene Referenzdaten etwa 10 % genauer: In der Kreuzvalidierung sank der Fehler von 0,89 auf 0,80 log-Einheiten.
- Jede Vorhersage hat ein 90-%-Vorhersageintervall und sagt, wenn eine Verbindung außerhalb der gut abgedeckten Chemie liegt.
- Das Intervall ist breit, etwa ±1,2 log-Einheiten. Das reicht für Screening und Rangfolge von Lösungsmitteln. Eine Messung ersetzt es nicht.
Die Frage hinter der Zahl
Früh in der Entwicklung ist der typische Fall eine Verbindung, die noch niemand gemessen hat. Wird sie in Wasser oder in Prozesslösungsmitteln zum Löslichkeitsproblem, und mit welchem Lösungsmittel sollen die ersten Versuche laufen? Eine Löslichkeitsvorhersage hilft dort nur, wenn zweierlei stimmt: Sie ist für unbekannte Verbindungen genau, und sie sagt, wie sicher sie ist. Dieser Artikel berichtet beides, mit den Einschränkungen, die zu jeder Zahl gehören. Alle Werte sind log10 der Löslichkeit in mol/L; eine log-Einheit ist ein Faktor 10 in der Konzentration.
Öffentlicher Benchmark: FastSolv
FastSolv (Attia et al., Nat. Commun. 16, 7497, 2025) stellt zwei Testsätze bereit, deren Verbindungen im Trainingssatz nicht vorkommen. Für diesen Vergleich wurde unser Modell neu trainiert, ausschließlich auf den Trainingsdaten des Benchmarks.
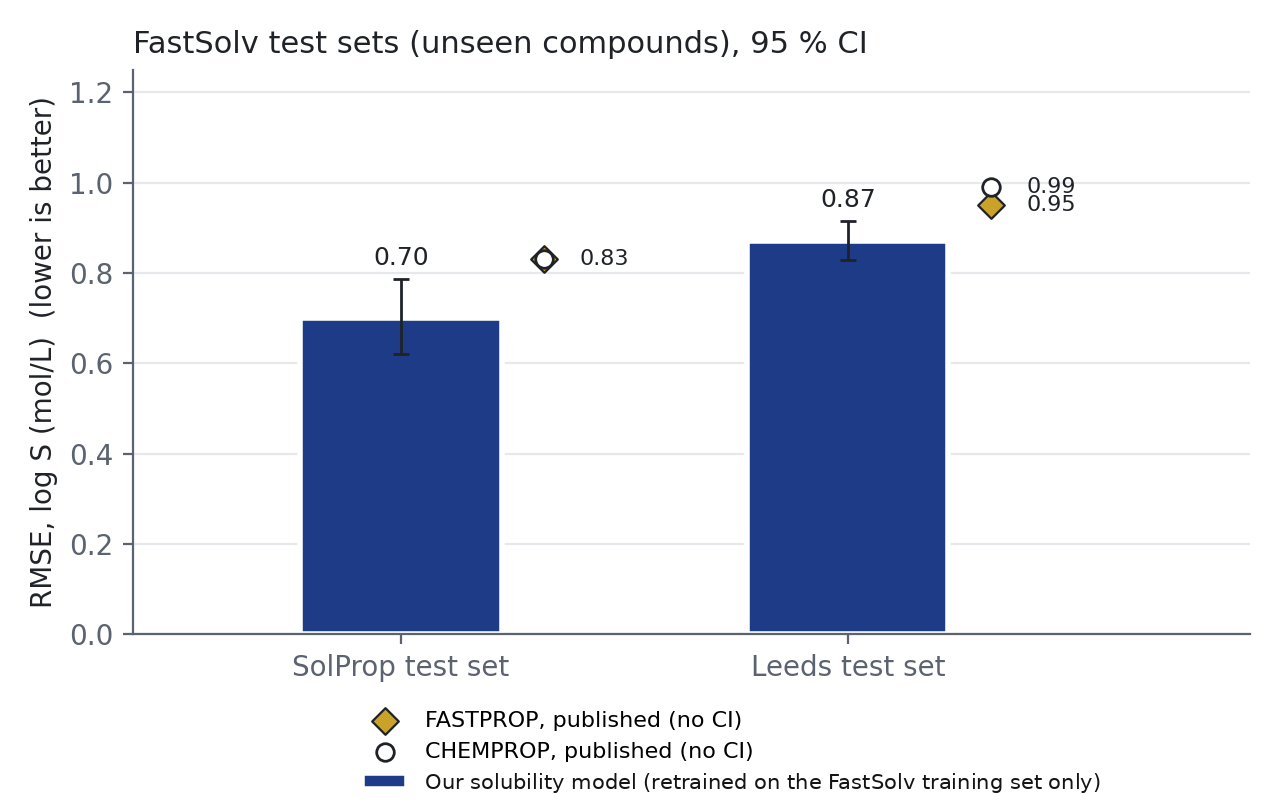
- Leeds-Testsatz: RMSE 0,87 log-Einheiten (95-%-KI 0,83 bis 0,92); publiziert sind 0,95 für FASTPROP und 0,99 für CHEMPROP.¹
- SolProp-Testsatz: RMSE 0,70 log-Einheiten (95-%-KI 0,62 bis 0,79); publiziert sind für FASTPROP und CHEMPROP je 0,83.¹
¹ Publizierte Werte aus der Veröffentlichung; nicht auf denselben Datenpunkten verglichen.
Neue Verbindungen ohne gemessene Referenzdaten
Der zweite Beleg ist eine interne Kreuzvalidierung, bei der je Fold ganze Verbindungen zurückgehalten werden, wiederholt mit drei unabhängigen Fold-Zuordnungen. Sie ist kein öffentlicher Benchmark, und das steht bei jeder Abbildung dabei.
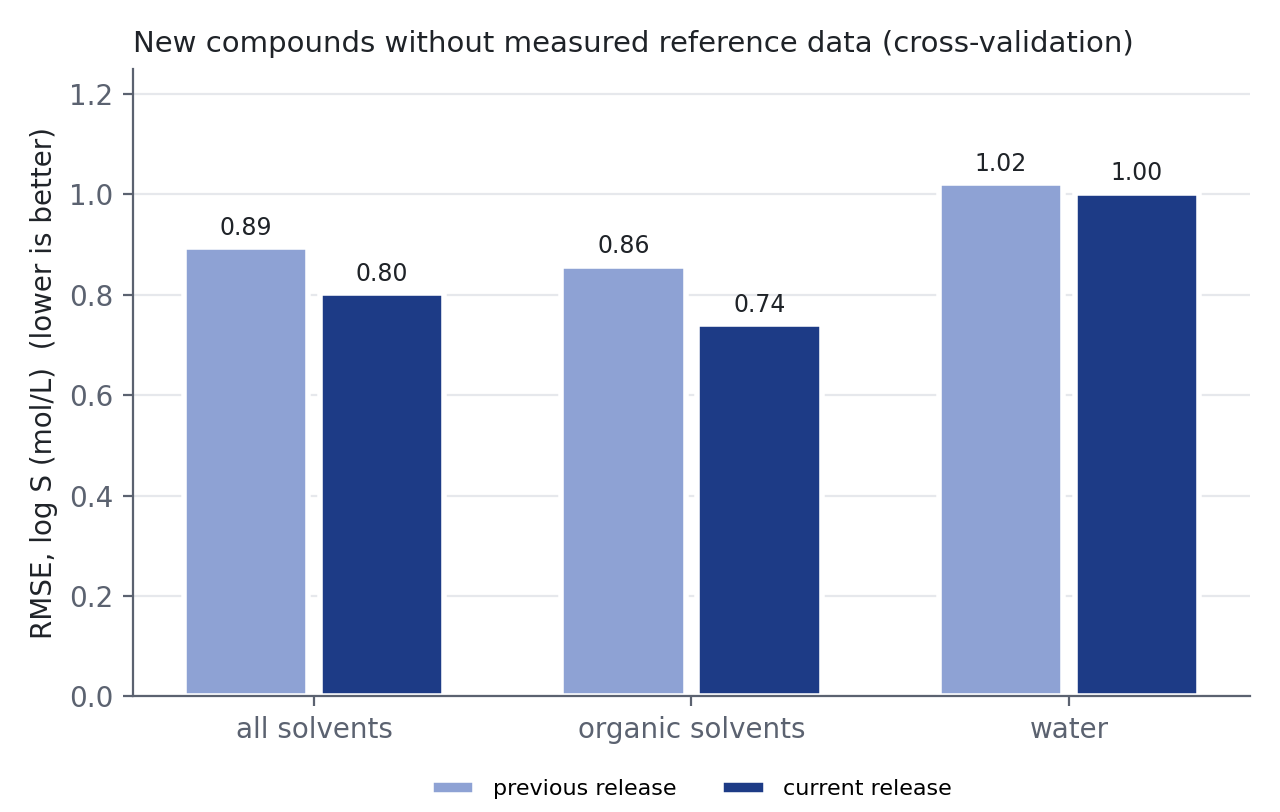
- Das aktuelle Release ist für neue Verbindungen ohne gemessene Referenzdaten etwa 10 % genauer: In der Kreuzvalidierung sank der Fehler von 0,89 auf 0,80 log-Einheiten, gleichermaßen in drei unabhängigen Wiederholungen.
- In organischen Lösungsmitteln beträgt der Gewinn für solche neuen Verbindungen etwa 13 % (0,86 auf 0,74 log-Einheiten in der Kreuzvalidierung).
- In Wasser ist die Änderung klein (1,02 auf 1,00).
- Für gut charakterisierte Verbindungen ist die Genauigkeit unverändert.
Wie sicher ist eine einzelne Vorhersage?
Jede Vorhersage hat ein 90-%-Vorhersageintervall; auf zurückgehaltenen Daten lag der wahre Wert in 90,6 % der Fälle darin. Für neue Verbindungen enthält das 90-%-Intervall des aktuellen Release den wahren Wert in der Kreuzvalidierung in 88 % der Fälle, vorher 80 %, bei gleicher Breite.
Das Intervall stimmt im Mittel, ist aber breit (etwa ±1,2 log-Einheiten) und für sehr schwer lösliche Verbindungen weniger verlässlich. Unterhalb von log S etwa −4, also rund 0,1 mmol/L, trifft es nur in etwa 80 % der Fälle. Für Lösungsmittelmischungen ist das Intervall als nicht kalibriert gekennzeichnet, weil die Abdeckung nur für Einzellösungsmittel gemessen wurde.
Das Werkzeug sagt außerdem, wenn eine Verbindung außerhalb der gut abgedeckten Chemie liegt. Innerhalb dieses Bereichs war der Fehler auf zurückgehaltenen Daten etwa 40 % kleiner (0,46 gegen 0,76 log-Einheiten). Außerhalb heißt vorsichtiger lesen, nicht falsch: Die Prüfung ist streng, die meisten zurückgehaltenen Vorhersagen liegen außerhalb.
Von der Zahl zur Prozessentscheidung
Ein log-S-Wert ist Mittel zum Zweck. In der Prozessentwicklung lauten die Fragen: welches Lösungsmittel, welche Einwaage, welche Ausbeute. Dieselben Rechnungen gehen deshalb weiter:
- Lösungsmittel-Shortlists werden vor der Rangfolge nach Flüssigbereich, Mischbarkeit und Status nach ICH Q3C gefiltert. Was Q3C nicht listet, ist als nicht gelistet markiert.
- Mischbarkeit stammt aus einer kuratierten Tabelle von 597 Lösungsmittelpaaren mit belegter Quelle je Aussage, einschließlich temperaturabhängiger Paare mit kritischer Entmischungstemperatur wie Methanol und n-Hexan.
- Kühlkristallisation: Das Werkzeug schlägt eine Einwaage vor, nennt die erwartete Ausbeute mit 90-%-Intervall und markiert eine Einwaage, bei der das meiste Produkt in Lösung bliebe.
- Wenn eine Route nicht funktionieren kann (Lösungsmittel nicht mischbar, Einwaage löst sich nicht, Kühlung kristallisiert nicht), sagt das Werkzeug das, statt eine Zahl auszugeben.
Die Ausbeuten sind Gleichgewichtswerte. Keimbildung, Kinetik, Polymorphie und Partikelgröße liegen außerhalb dessen, was eine Rechnung aus der Struktur leisten kann.
Was diese Zahlen nicht zeigen
- Keine unabhängige Validierung. FastSolv ist ein öffentlicher Benchmark, den wir selbst ausgewertet haben; die Vergleichswerte stammen aus der Veröffentlichung und wurden nicht auf denselben Datenpunkten ermittelt.
- Keine Zusage für eine einzelne Verbindung. Ein RMSE ist eine Populationsstatistik.
- Kein Ersatz für eine Messung. Bei etwa ±1,2 log-Einheiten ist das Intervall für die Rangfolge von Kandidaten und Lösungsmitteln gemacht, nicht für eine Spezifikation.
- Bekannte Arzneistoffe sind eine Plausibilitätsprüfung, keine Validierung. Vertraute Verbindungen wie Acetylsalicylsäure oder Paracetamol sind in den Trainingsdaten; ein guter Treffer dort sagt wenig über ein neues Molekül.
Am eigenen Molekül ausprobieren
Molekül zeichnen und log S mit 90-%-Intervall und Domänenprüfung, Lösungsmittel-Shortlists und Kristallisationsausbeuten bekommen. → CovaSketch
FAQ
Wie genau ist die Löslichkeitsvorhersage für neue Verbindungen?
Auf dem FastSolv-Benchmark liegt der RMSE für Verbindungen außerhalb der Trainingsdaten bei 0,70 log-Einheiten (SolProp) und 0,87 (Leeds). Publiziert sind für FASTPROP 0,83 und 0,95, allerdings nicht auf denselben Datenpunkten ermittelt.
Was bedeutet das 90-%-Intervall?
Auf zurückgehaltenen Daten lag der wahre Wert in 90,6 % der Fälle darin. Es ist etwa ±1,2 log-Einheiten breit und für sehr schwer lösliche Verbindungen weniger verlässlich.
Ersetzt die Vorhersage eine Löslichkeitsmessung?
Nein. Sie reicht, um Lösungsmittel und Kandidaten zu ordnen und Versuche an Systemen zu vermeiden, die nicht funktionieren können.
Sagt sie Polymorphie oder Kristallisationskinetik voraus?
Nein. Kristallisationsausbeuten sind Gleichgewichtswerte.
Methodik und Daten
FastSolv-Testsätze SolProp (5.230 Messungen, 101 Verbindungen; die Veröffentlichung nennt N = 5.700) und Leeds (1.294 Messungen, 1.017 Verbindungen), ausgewertet mit dem aktuellen Release, neu trainiert nur auf dem FastSolv-Trainingssatz; Mittel aus fünf Trainingsläufen; 95-%-KI aus 1.000 Bootstrap-Stichproben der Testverbindungen. Der Leeds-Testsatz hat keine angegebene Datenlizenz und wird nur zur Auswertung genutzt. Kreuzvalidierung: ganze Verbindungen je Fold zurückgehalten, drei unabhängige Wiederholungen. Intervall- und Domänenwerte auf zurückgehaltenen Daten: 11.814 Messungen von Verbindungsfamilien, die nie im Training waren, vorheriges Release. Training data include BigSolDB 2.0/2.2 (Krasnov et al., CC BY 4.0), AqSolDB (Sorkun et al., CC0), OPERA/PHYSPROP (US EPA, CC0), Biogen ADME (Fang et al.), ChEMBL (CC BY-SA 3.0) and the open data collections of Lang, Bradley & Acree (CC BY 4.0). Datenstand: 24.10.2026.